Appearance
环境代码都装好了,连激活都不用——云服务器上一条命令搞定分子对接
写在前面:想筛一个可能结合靶点蛋白的小分子,第一步往往是分子对接——把小分子"放进"蛋白口袋里,算算结合得牢不牢。听起来酷,做起来劝退:装 AutoDock Vina、配 Python 环境、把蛋白和小分子转成 PDBQT、手动框对接区域……这套流程现在被打包成了一个脚本,环境激活都内置在里面。你要做的只有三件事:生成配置、填两个编号、回车。
单次对接:约 1–5 min|GPU:无需|CPU:主要计算资源|内存:低占用|输入:PDB ID + PubChem CID|输出:最佳结合构象 + 复合物结构
一、分子对接是在"算什么"
蛋白质执行功能,常常从"结合一个小分子"开始——药物起效也是如此。分子对接就是在计算机里模拟这件事:
把小分子(配体)摆到蛋白(受体)表面的各个位置、各个朝向,穷举可能的结合姿势;
对每种姿势打一个"亲和能"分数(单位 kcal/mol)
按分数排序,最优姿势就是预测的结合模式。
AutoDock Vina 是这个领域用得最广的开源工具之一(Trott & Olson, J. Comp. Chem. 2010;Eberhardt 等, J. Chem. Inf. Model. 2021),速度快、精度可靠。这次部署的脚本在 Vina 外面包了一整条自动化流水线。
二、三步走:init → 填配置 → 运行
这次连 source 激活环境都不用——脚本内部会自动激活公共环境 vina-docking,全程无感。登录服务器后,先在自己目录下建个工作文件夹并进入:
bash
mkdir -p ~/tool
cd ~/tool
将共享代码下载并解压到自己的 ~/tool/ 目录下并进入项目vina-docking
bash
wget -P ~/tool "http://iyun70.com:8011/softs/shareCodes/vina-docking.zip"
unzip vina-docking.zip
cd ~/tool/vina-docking
bash ~/tool/vina-docking/run.sh -h可以获取帮助信息,使用前了解
第一步,生成配置文件:
bash
bash ~/tool/vina-docking/run.sh init当前目录下会多出一个 config.yaml,打开它,要填的核心就三个空:
yaml
protein:
  pdb_id: 3RT3          # 蛋白的 PDB 数据库编号
ligand:
  pubchem_cid: 52949968  # 小分子的 PubChem CID 编号
output:
  path: .               # 结果输出目录(默认当前目录,别填公共路径)
蛋白结构和小分子结构都不用自己准备——脚本会按这两个编号自动从 PDB 和 PubChem 下载。下面的 docking 段是进阶参数(cpu 核数、搜索广度 exhaustiveness、输出构象数 num_modes),默认值直接能用,不懂不动。
第二步(也是最后一步),直接进行主分析:
bash
bash ~/tool/vina-docking/run.sh config.yaml然后等结果出现在自己目录就行。想挂后台、断开 SSH 也不怕的话:nohup ~/tool/vina-docking/run.sh config.yaml > docking.log 2>&1 &
三、演示实例:抗病毒蛋白 × 小分子
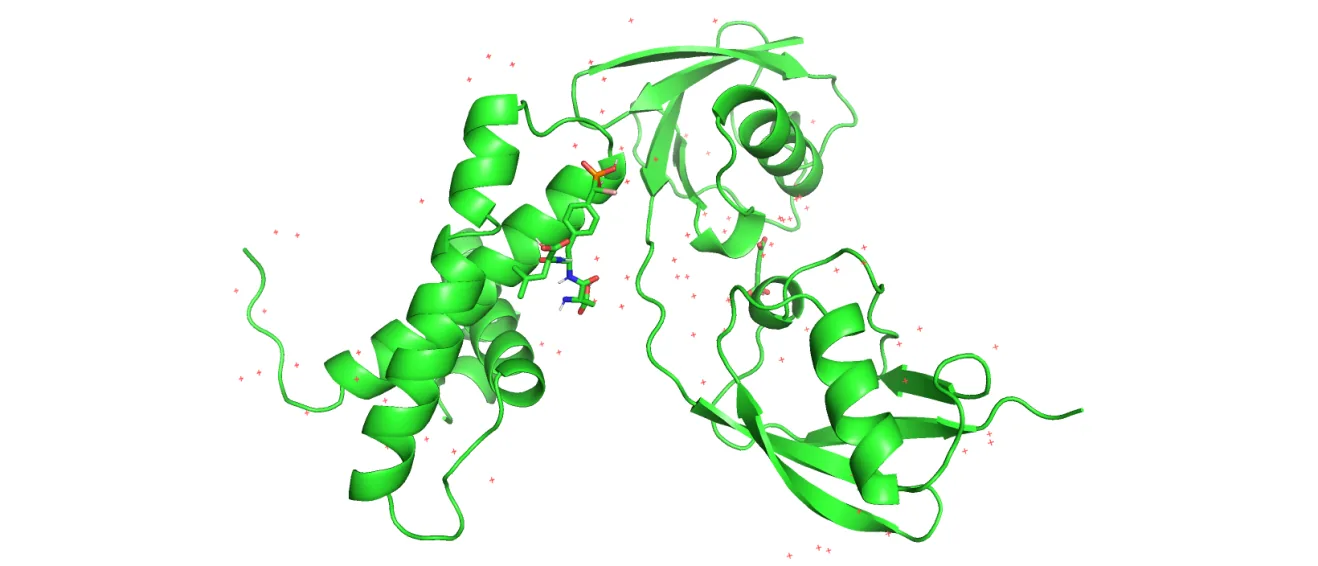
这次演示用的蛋白是 PDB 编号 3RT3——人源抗病毒因子 ISG15 与流感病毒非结构蛋白 NS1B 的复合物结构(2051 个原子),配体是 PubChem 编号 52949968 的一个小分子。两个编号填进配置,一条命令下去,脚本自动走完八步:
下载结构:按 PDB 编号和 CID 编号自动拉取 protein.pdb 和 ligand.sdf;
准备受体 / 配体:自动完成加氢、加电荷并转成 Vina 专用的 PDBQT 格式(这步手动做最折腾,现在无感跳过);
自动框选对接区域:盲对接(blind docking)模式,根据蛋白整体尺寸自动生成对接盒,不用手动画格子;
Vina 对接:穷举小分子的结合姿势并打分;
提取最优构象 → 转回 PDB → 拼出蛋白-配体复合物:直接给你能拿去看图软件打开的最终结构。
四、结果:一张打分表 + 一套结构文件
对接完成后,终端会打出全部构象的打分表(按亲和能排序):
text
 mode |   affinity | dist from best mode
     | (kcal/mol) | rmsd l.b.| rmsd u.b.
-----+------------+----------+----------
   1       -6.108          0          0
   2       -5.899      1.586      2.098
   3       -5.576      4.635      10.16
   4       -5.543      18.09      21.62
   5       -5.523      38.93      41.38
  ...
头号构象亲和能 -6.108 kcal/mol。经验上,亲和能 ≤ -5 kcal/mol 说明有可见的结合能力,越负结合越稳;前两名分数接近且 RMSD 小,说明最优姿势站得比较稳,不是偶然撞出来的。
输出目录里是一套完整的结构文件:原始蛋白 protein.pdb、配体 ligand.sdf、两者的 PDBQT、最优构象 best_pose.pdb,以及直接可用于可视化/发文章的复合物 complex_best_pose.pdb——用 PyMOL、VMD 或 ChimeraX 打开,就能看到小分子嵌在蛋白表面的样子。
五、小结
回顾一下这次的体验:
不用装环境、不用激活环境——脚本内置激活公共环境 vina-docking,登录即用;
不用自己下载和转换结构——给两个数据库编号,下载、加氢、转格式全自动;
不用手动画对接盒——盲对接自动框选全蛋白;
结果只写自己的目录,公共路径只读不写。
这套流程已经部署在云生信服务器上:带上你感兴趣的蛋白 PDB 编号和小分子 CID 编号,登录就能跑出同款结果。如果有公共数据库或环境方面的需求、以及时间紧张并希望直接拿到分析结果的想法,可以咨询服务器销售顾问,云生信顾问提供人工服务:数据处理、绘图与结果解读,按项目交付。