Appearance
细胞分化往哪走?Monocle2 一条轨迹画清楚——云服务器预装,登录即跑
看别人的单细胞文章,拟时序轨迹图分支清晰、伪时间梯度漂亮、基因动态热图层次分明;轮到自己用 Monocle2,从 Seurat 对象转 Monocle、降维、排序、画轨迹、找分支点、画热图……步骤多、参数杂、一个报错卡半天。
这篇把 Monocle2 拟时序分析的全流程可视化封装成一篇代码,代码、数据、环境放在一个文件夹,全部预置在服务器公共路径,使用绝对路径激活,登录直接跑。
一、Monocle2 的“六件套”可视化
Monocle2 是单细胞拟时序分析的经典工具,核心就围绕一件事:
把细胞按分化顺序排成一条线,再告诉你关键的分叉口在哪。
围绕这件事,它产出的六类图基本覆盖了发文所需的全部拟时序可视化:
| 图 | 函数 | 看什么 |
|---|---|---|
| 细胞轨迹图 | plot_cell_trajectory | 细胞在二维流形上的分布,按状态或伪时间着色 |
| 基因动态趋势图 | plot_genes_in_pseudotime | 指定基因沿伪时间轴的表达变化曲线 |
| 分支热图 | plot_genes_branched_heatmap | 分支点两侧基因的表达模式差异 |
| 拟时序基因热图 | plot_pseudotime_heatmap | 全基因组层面随伪时间显著变化的基因聚类 |
| 状态统计图 | plot_cell_trajectory(..., color_by = "State") | 各状态细胞的数量与空间分布 |
| 伪时间梯度图 | plot_cell_trajectory(..., color_by = "Pseudotime") | 从起点到终点的连续时间梯度 |
共同特点:一张图讲清楚一个生物学问题。轨迹图看分化方向,热图看基因动态,分支图看命运决定——组合起来就是一套完整的故事线。
二、用大白话讲一遍原理
把单细胞数据想象成一张城市地铁图。每个细胞是一个地铁站,基因表达量就是各站的人流量。Monocle2 的工作分三步:
- 铺轨(DDRTree 降维):根据各站的人流量变化规律,反推地铁线路是怎么铺的——哪站是起点、哪站是换乘点、哪条线通往哪个终点。DDRTree 算法把高维的地铁网络压成一张二维地图。
- 排号(
orderCells):给每个站标上“距起点的距离”,这就是伪时间(Pseudotime)。越靠近起点的站,分化程度越低;越远的,越成熟。 - 找分叉口(BEAM):看哪条线路在哪个换乘点分道扬镳,鉴定决定细胞命运走向的关键基因。
你不需要懂背后的数学,只需要知道:跑完这套流程,你能得到一张“细胞分化地铁图”。
三、环境:登录即用
Monocle2 已预装在公共 condaR 环境中,代码、数据、环境放在一个文件夹,环境绝对路径为:
text
/media/share/share_code/一篇代码搞定monocle2的所有可视化/monocle环境内置 R 4.4.3。RStudio 自带 R 与该环境大版本一致即可直接使用:4.4.x 通用 4.4,4.5.x 通用 4.5;可先在 RStudio Console 输入 R.version.string 查看版本。
情况一:版本匹配
直接在 RStudio Console 指定库路径并加载:
r
.libPaths("/media/share/share_code/一篇代码搞定monocle2的所有可视化/monocle/lib/R/library")
library(monocle)
情况二:版本不匹配
在 RStudio Terminal 激活环境,再输入大写 R:
bash
source /media/share/share_code/一篇代码搞定monocle2的所有可视化/monocle/bin/activate
R
工作目录请设到自己目录,不在公共路径下读写。
四、实战:从 Seurat 到六张拟时序图
示例数据是一份 Seurat 对象,需要先从 Seurat 构建 Monocle 的 CellDataSet,再跑降维、排序、可视化。完整流程一条代码到底,不需要自己拆步骤。
4.1 数据导入与 Monocle 对象构建
先在 RStudio Terminal 创建工作目录并启动公共环境:
bash
mkdir -p ~/monocle2_demo
cd ~/monocle2_demo
source /media/share/share_code/一篇代码搞定monocle2的所有可视化/monocle/bin/activate
R
进入 R 后,指定公共库路径、读取示例数据并构建 Monocle 对象:
r
.libPaths("/media/share/share_code/一篇代码搞定monocle2的所有可视化/monocle/lib/R/library")
library(monocle)
library(Seurat)

# 读取示例数据(Seurat 对象)
raw_seurat <- readRDS(
  "/media/share/share_code/一篇代码搞定monocle2的所有可视化/test.rds"
)

# 构建 Monocle CellDataSet
pd <- new("AnnotatedDataFrame", data = raw_seurat@meta.data)
fData <- data.frame(
  gene_short_name = row.names(raw_seurat),
  row.names = row.names(raw_seurat)
)
fd <- new("AnnotatedDataFrame", data = fData)

# expressionFamily:TPM/FPKM 数据用 tobit(Lower = 0.1),count 数据用 negbinomial.size()
# Seurat v5 版本取 counts
counts_matrix <- GetAssayData(raw_seurat, assay = "RNA", layer = "counts")

cds <- newCellDataSet(
  as(as.matrix(counts_matrix), "sparseMatrix"),
  phenoData = pd,
  featureData = fd,
  lowerDetectionLimit = 0.5,
  expressionFamily = negbinomial.size()
)

# 估计 size factors 和 dispersions(negbinomial.size 必需)
cds <- estimateSizeFactors(cds)
cds <- estimateDispersions(cds)

# 挑选高离散基因作为排序基因
disp_table <- dispersionTable(cds)
ordering_genes <- subset(
  disp_table,
  mean_expression >= 0.1 & dispersion_empirical >= 1 * dispersion_fit
)$gene_id
cds <- setOrderingFilter(cds, ordering_genes)

# 降维(DDRTree)
tryCatch(
  {
    cds <- reduceDimension(cds, max_components = 2, method = "DDRTree")
  },
  error = function(e) {
    cds <- reduceDimension(
      cds,
      max_components = 2,
      method = "DDRTree",
      auto_param_selection = FALSE
    )
  }
)

# 排序细胞
cds <- orderCells(cds)
图 1|细胞轨迹图(按状态着色)
r
plot_cell_trajectory(cds, color_by = "State")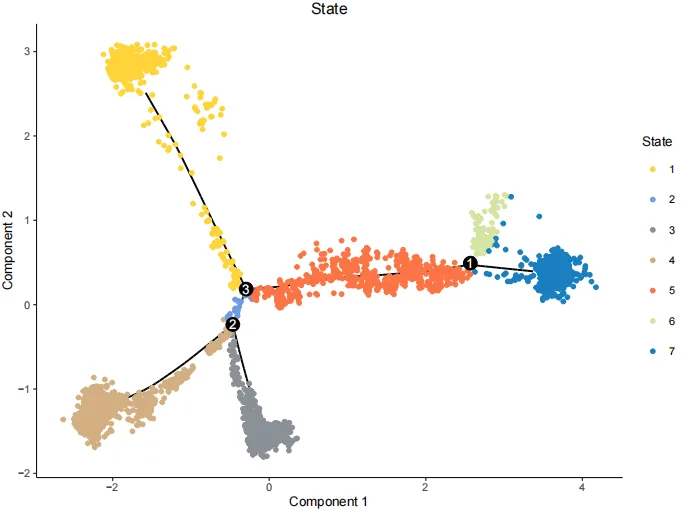
细胞在二维流形上铺展开,不同颜色代表不同的推断状态(State),能一眼看出细胞群体分成了几条“线”、几个“簇”。
也可按细胞类型着色:
r
plot_cell_trajectory(cds, color_by = "final_cell_type")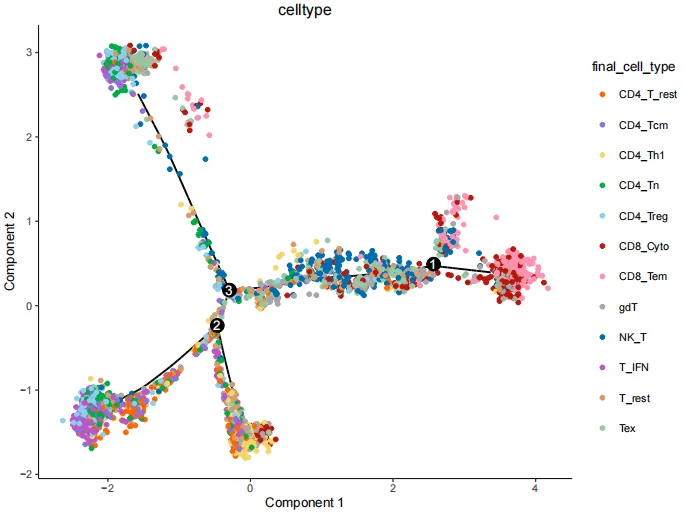
图 2|细胞轨迹图(按伪时间着色)
r
plot_cell_trajectory(cds, color_by = "Pseudotime")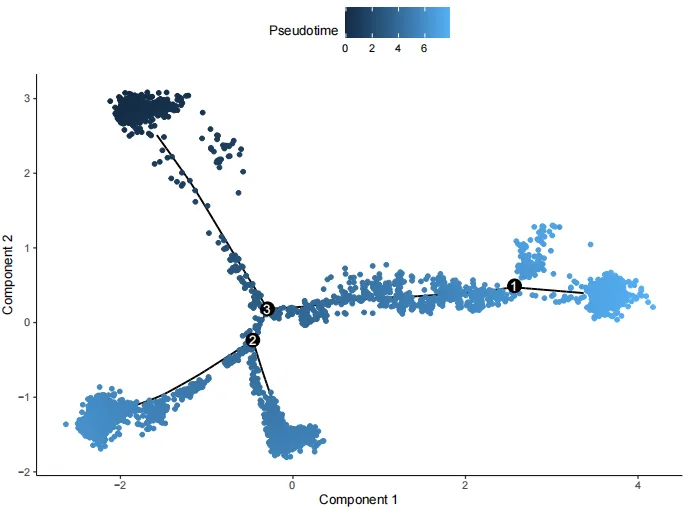
同一轨迹,这次按伪时间渐变着色——从蓝到红的连续梯度,就是细胞从低分化到高分化的“时间轴”。
图 3|关键基因动态趋势
r
marker_genes <- c("PDCD1", "CCR7") # 请替换为实际基因名
cds_subset <- cds[marker_genes, ]
plot_genes_in_pseudotime(cds_subset, color_by = "State")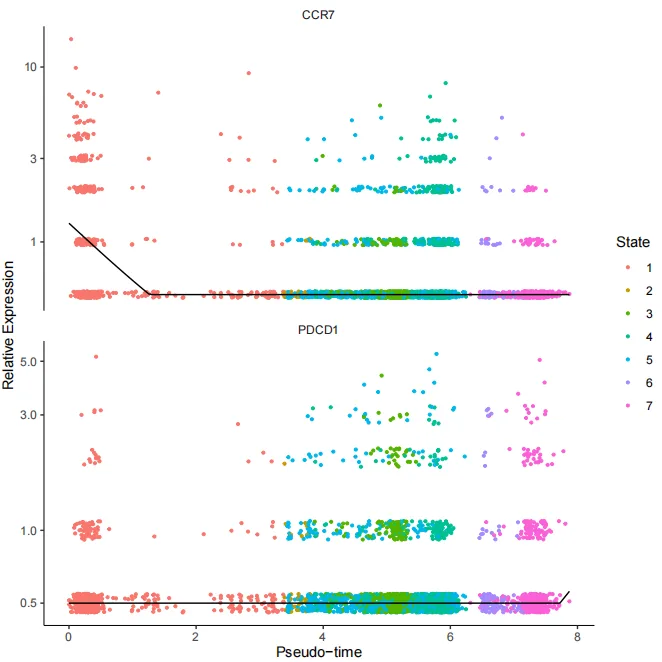
指定几个你关心的 marker 基因,看它们沿伪时间轴的表达起伏。哪些基因在分化早期高表达、哪些在晚期才启动,曲线一目了然。
图 4|分支命运决定热图
r
beam_res <- BEAM(cds, branch_point = 2)
plot_genes_branched_heatmap(cds, branch_point = 2, num_clusters = 4)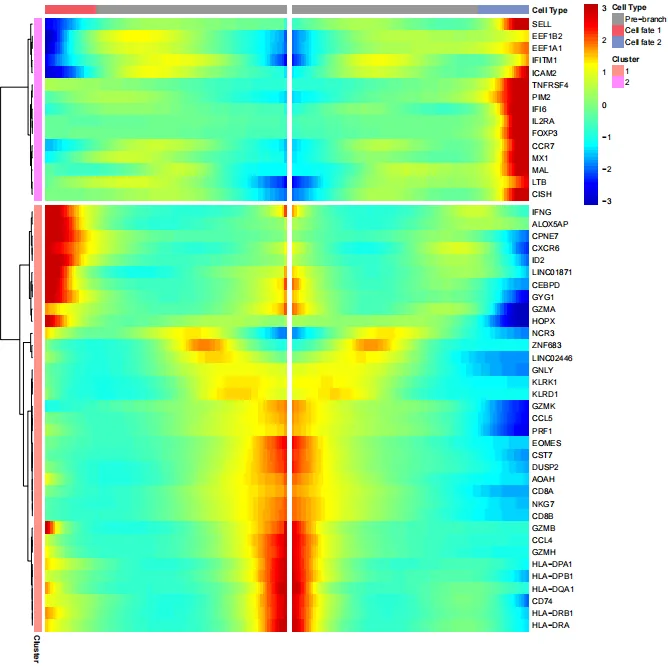
在分支点两侧,哪些基因的表达模式发生了“分道扬镳”式的变化?热图按聚类排列,每一类基因对应一种命运走向的分子标签。
如果轨迹没有分支,可跳过此步骤。
图 5|拟时序相关基因热图(Top 50)
r
p <- plot_pseudotime_heatmap(
  cds,
  num_clusters = 2,
  show_rownames = TRUE,
  return_heatmap = TRUE
)
ggsave(
  "pseudotime_dependent_gene_heatmap_top50.pdf",
  p,
  width = 9,
  height = 5,
  limitsize = FALSE
)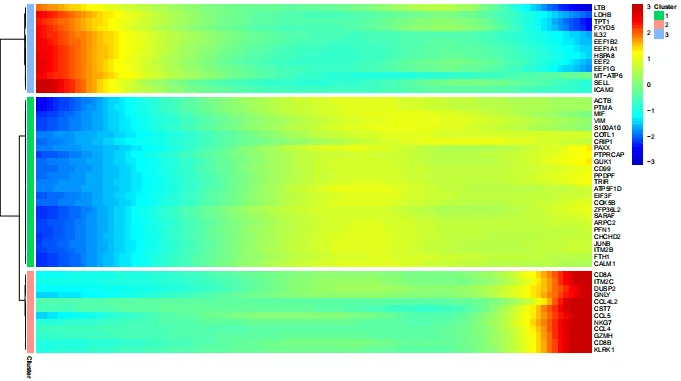
全基因组层面筛选随伪时间显著变化的基因,取 Top 50 画热图并按表达模式聚类。行是基因、列是细胞,颜色深浅是表达量——这张图直接放进文章当 Figure 都够格。
表 6|基因聚类结果表
热图聚类结果同时输出为表格文件,方便后续按 cluster 提取基因名单做功能注释:
r
clusters <- cutree(p$tree_row, k = 2)
clustering <- as.data.frame(clusters) %>%
  rownames_to_column(var = "gene")
write.table(
  clustering,
  "pseudotime_dependent_gene_heatmap_top50_gene_by_cluster11.xls",
  sep = "\t",
  quote = FALSE,
  col.names = TRUE,
  row.names = FALSE
)
五、结果文件一览
运行完成后,五张图和一个配套表格输出到你的个人工作目录:
trajectory_state.pdf——细胞轨迹图(状态着色)trajectory_pseudotime.pdf——细胞轨迹图(伪时间着色)gene_pseudotime_trends.pdf——基因动态趋势图branch_heatmap.pdf——分支命运决定热图pseudotime_dependent_gene_heatmap_top50.pdf——拟时序基因热图(Top 50)pseudotime_dependent_gene_heatmap_top50_gene_by_cluster11.xls——基因聚类表
六、小结
- Monocle2 = 经典拟时序分析工具,从 Seurat 对象构建 → DDRTree 降维 → 伪时间排序 → 分支命运分析,一张“细胞分化地铁图”讲清楚分化故事。
- 五张图覆盖发文所需的拟时序可视化:轨迹图、伪时间梯度、基因动态、分支热图、全基因热图、聚类表格。
- 代码、数据、环境放在一个文件夹,使用绝对路径激活,登录即用。
- 工作目录设到自己目录,跑完结果就在你手里。
想给自己的单细胞数据也画一条“分化轨迹”,欢迎联系我们的技术团队开通体验。