Appearance
一个SCOP包跑完单细胞全流程——轻松玩转一站式分析
做单细胞分析最烦的是什么?不是某个分析不会,而是每换一个分析就要换一个工具、配一套环境:标准化要用NormalizeData + FindVariableFeatures + ScaleData + RunPCA + FindClusters + RunUMAP、质控要用scDblFinder + decontX、整合要用Harmony、注释要用KNN 映射、干性要用CytoTRACE 2、轨迹要用RunMonocle3和RunSlingshot、差异要用Wilcoxon、富集要用R clusterProfiler + DOSE + org.Mm.eg.db……工具之间数据格式还互相不认,光是把这一整套跑通,就得折腾好几天。
这篇介绍的R包SCOP,把这条流水线整个装进了一个包——standard_scop管标准化,RunCellQC管质控,integration_scop管整合,RunKNNMap + RunKNNPredict管注释,RunCytoTRACE管干性,RunMonocle3 + RunSlingshot管轨迹,RunDEtest管差异,RunEnrichment + RunGSEA管富集。从标准化、质控、整合、注释、干性、轨迹、差异到富集,一个包全覆盖。我们在云服务器上用它把单细胞分析完整跑了一遍,10个环节、25 张图,全程一套语法、零切换。环境和代码已部署在公共路径,登录即用。
一、SCOP
SCOP(Spatial and Cellular Omics analysis Pipeline)是一个R语言的一站式单细胞与空间组学分析包,在广受好评的SCP包基础上升级开发,主要改进:全面兼容Seurat v5(SCP对v5支持不全是个老痛点);稳定性大修:修复大量已知问题,全部函数通过devtools::check();新增并行框架:各操作系统体验一致。
功能覆盖:质控、十几种批次整合、自动细胞注释、差异与扰动分析、富集分析、转录因子活性、细胞干性、轨迹推断、细胞通讯、空间转录组分析——别人是一个工具做一件事,SCOP是一个包做一条流水线。
二、公共环境
R包本身装进服务器公共R库,分析所需的环境已放到公共路径。
任何账号登录后,终端执行以下命令创建工作目录并进入目录:
bash
mkdir -p ~/tool
cd ~/tool
将共享代码下载并解压到自己的 ~/tool/ 目录下并进入项目SCOP
bash
wget -P ~/tool "http://iyun70.com:8011/softs/shareCodes/SCOP.zip"
unzip SCOP.zip
cd ~/tool/SCOP
直接用服务器上预装好的公共R环境scop_env,通过以下命令进入:
bash
~/tool/SCOP/scop_env/bin/R直接复制粘贴代码进行运行,建议每次执行一段代码。路径已配置好,不用修改!
三、一条流水线跑到底
使用SCOP自带的演示数据集集pancreas_sub和panc8_sub,不用到处找数据。以下代码为主要函数的使用展示,具体的绘图代码详见~/tool/SCOP/SCOP.R。
进入工作目录加载R包SCOP
r
setwd("~/tool/SCOP/")
library(scop)
加载演示数据pancreas_sub:
r
pancreas_sub <- readRDS("./data/pancreas_sub.rds")
print(pancreas_sub)
1. 标准分析流程(标准化、高变基因、PCA、降维、聚类)
r
pancreas_sub <- suppressWarnings(RunStandardWorkflow(pancreas_sub))
print(pancreas_sub)
2. 细胞质控(双细胞检测、异常值过滤、UMI、基因数、线粒体比例)
r
pancreas_sub <- suppressWarnings(RunCellQC(pancreas_sub))
print(pancreas_sub)
3. 数据整合分析(8个人类胰腺数据)
r
panc8_sub <- readRDS("./data/panc8_sub.rds")
print(panc8_sub)
panc8_sub <- suppressWarnings(integration_scop(
  srt_merge = panc8_sub,
  batch = "tech",
  integration_method = "Harmony"))
4. 映射与自动注释
r
# 重命名特征基因并将小鼠数据映射到人类参考数据上
genenames <- make.unique(thisutils::capitalize(rownames(panc8_sub[["RNA"]]),
                                               force_tolower = TRUE))
names(genenames) <- rownames(panc8_sub)
panc8_rename <- RenameFeatures(panc8_sub, newnames = genenames, assays = "RNA")
srt_query <- RunKNNMap(srt_query = pancreas_sub, srt_ref = panc8_rename,
                       ref_umap = "HarmonyUMAP2D")
# 使用人类单细胞参考数据进行注释
pancreas_sub <- RunKNNPredict(srt_query = pancreas_sub, srt_ref = panc8_rename,
                              ref_group = "celltype", filter_lowfreq = 20)
5. 细胞效力分析
r
pancreas_sub <- suppressWarnings(RunCytoTRACE(pancreas_sub,
                                              species = "Mus_musculus",
                                              cores = 6))
6. Monocle3轨迹推断
r
# 以Ductal亚型的第一个细胞为起点构建轨迹
ductal_cells <- colnames(pancreas_sub)[pancreas_sub$SubCellType == "Ductal"]
pancreas_sub <- RunMonocle3(pancreas_sub, group.by = "SubCellType",
                            root_cells = ductal_cells[1])
trajectory <- pancreas_sub@tools$Monocle3$trajectory
milestones <- pancreas_sub@tools$Monocle3$milestones
7. Slingshot轨迹推断
r
# 指定起点Ductal和终点Alpha/Beta:
pancreas_sub <- suppressWarnings(
  RunSlingshot(pancreas_sub, group.by = "SubCellType", reduction = "UMAP",
               start = "Ductal", end = c("Alpha", "Beta"),show_plot = FALSE))
8. 差异分析
r
pancreas_sub <- RunDEtest(pancreas_sub, group.by = "CellType",
                          fc.threshold = 1, only.pos = FALSE,
                          cores = 6)
9. GO富集分析
r
pancreas_sub <- RunEnrichment(
  pancreas_sub, group.by = "CellType", db = "GO_BP",
  species = "Mus_musculus",
  DE_threshold="avg_log2FC > log2(1.5) & p_val_adj < 0.05",
  cores = 6)
10. GSEA分析
r
pancreas_sub <- RunGSEA(pancreas_sub, group.by = "CellType", db = "GO_BP",
                        species = "Mus_musculus",
                        DE_threshold = "p_val_adj < 0.05", cores = 6)
四、结果展示
图 1|细胞分群全景
1000个胰腺细胞分得清清楚楚——5大类型(Ductal 253、Endocrine 355、Pre-endocrine 156、Ngn3-high-EP 169、Ngn3-low-EP 67)、8个亚型。
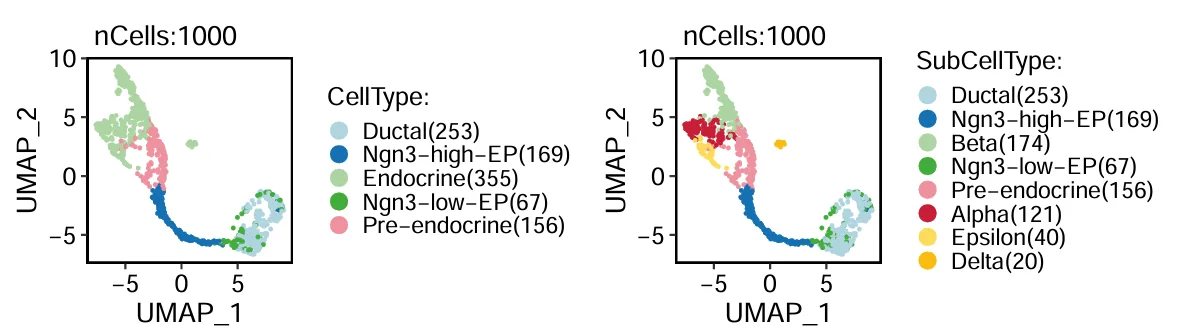
图 2|细胞质控一览
按细胞类型统计质控通过与标记比例。
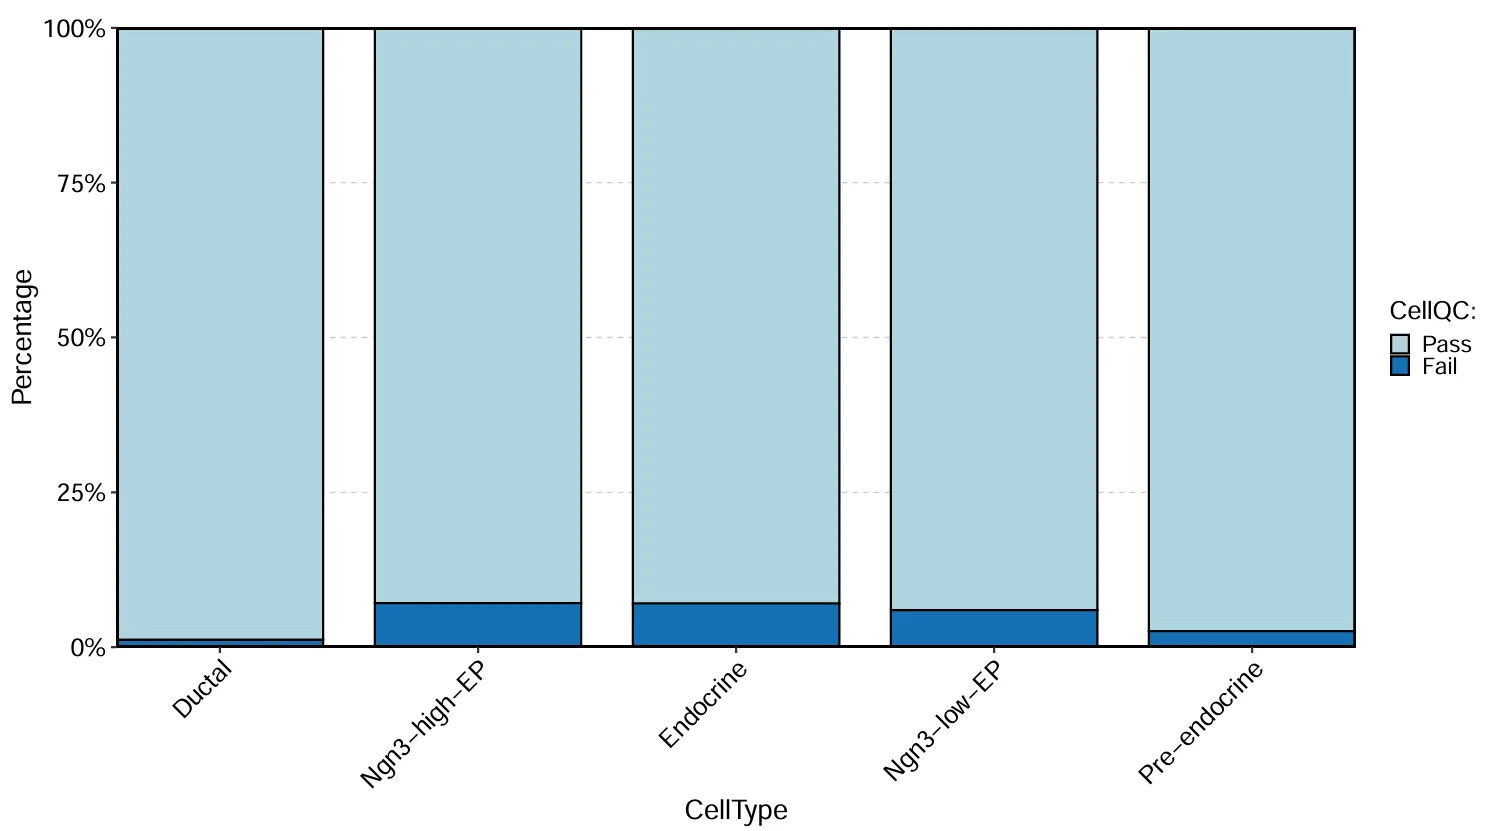
图 3|多样本Harmony整合
左图按技术平台着色、右图按细胞类型着色——不同平台的同类细胞混合均匀,提示批次效应被有效校正。
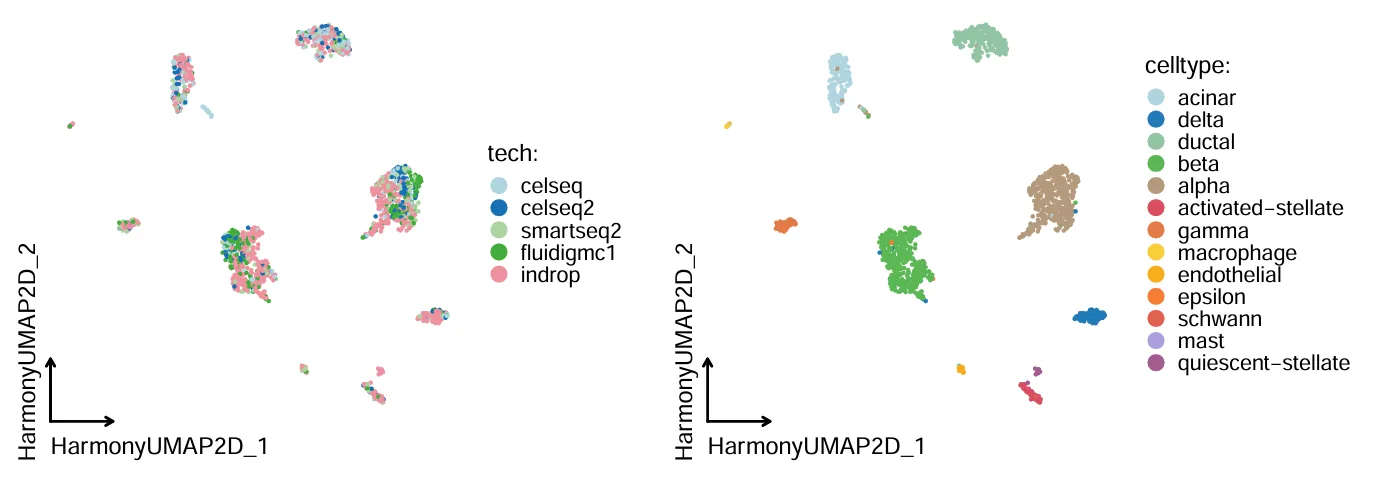
图 4|自动细胞注释
以单细胞参考数据做KNN映射预测,每个细胞被逐一标注为参考中的具体类型——注释结果与标准分群互相印证。
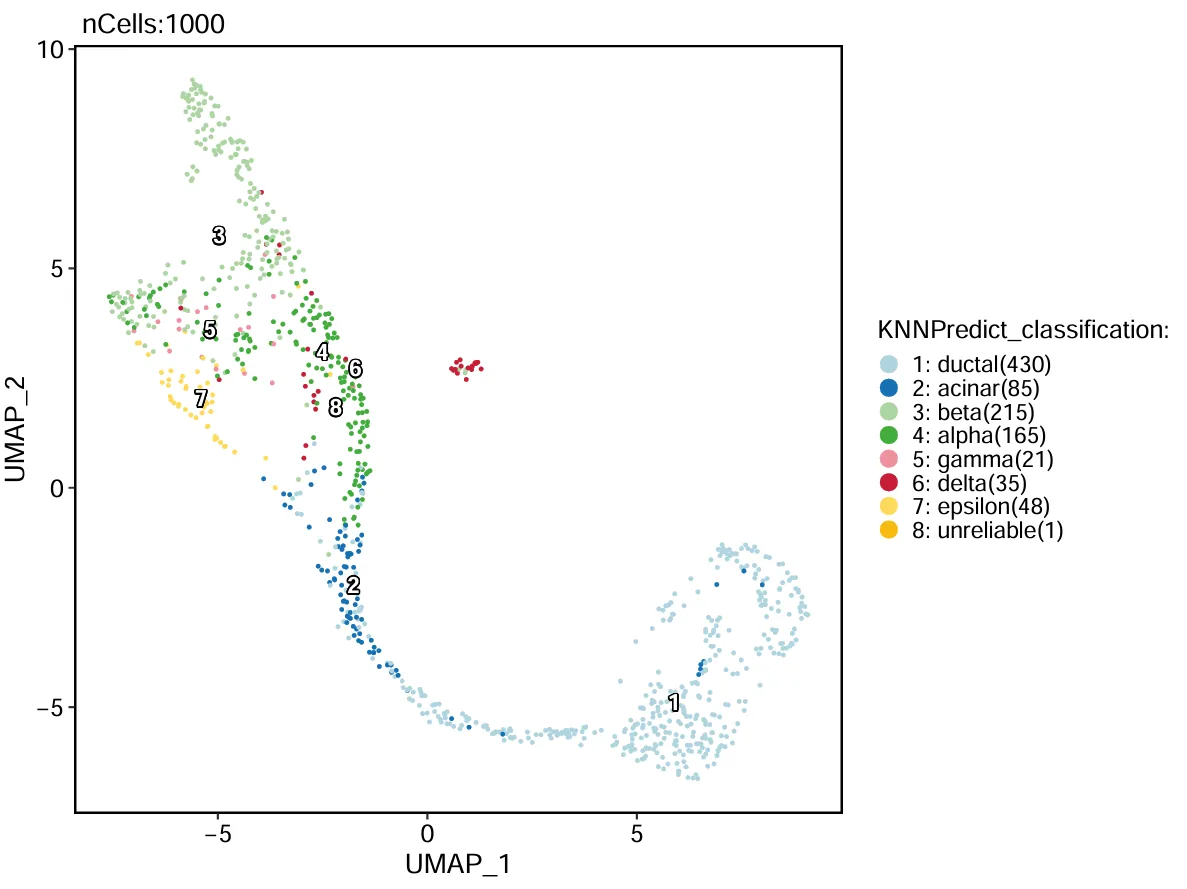
图 5|细胞干性评分
CytoTRACE 2为每个细胞计算干性分数并自动分级——Ngn3-high-EP、Pre-endocrine等祖细胞区域干性明显更高,符合发育生物学预期。
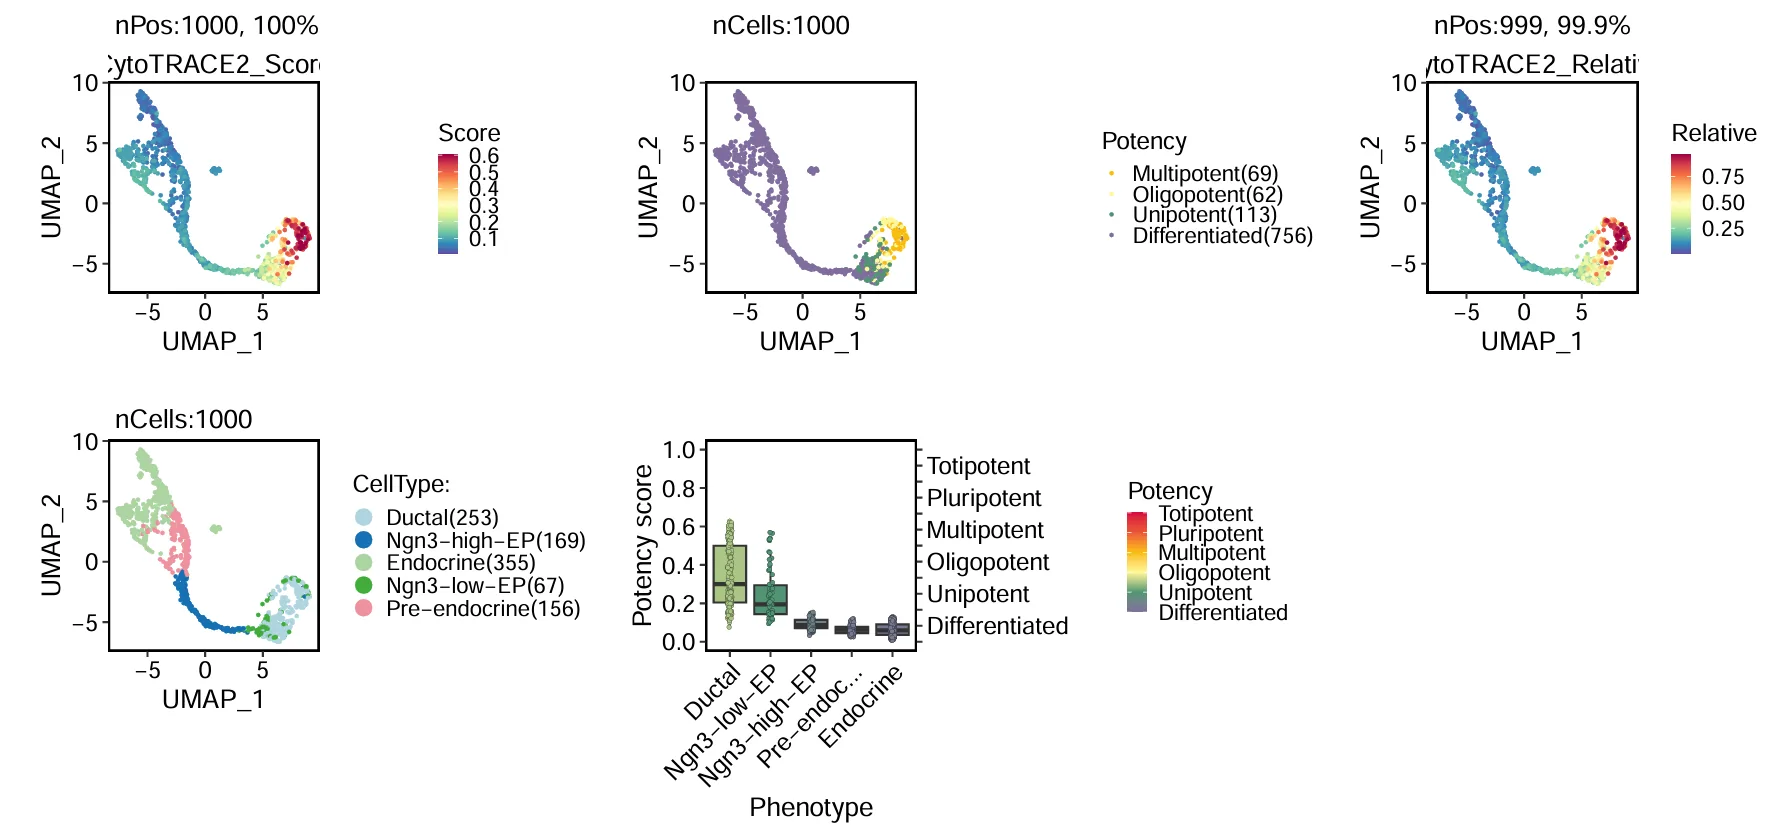
图 6|Monocle3轨迹与拟时序
分区、聚类、亚型、拟时序四联图叠加轨迹骨架,推断出的分化路径与已知的胰腺内分泌发育过程一致。
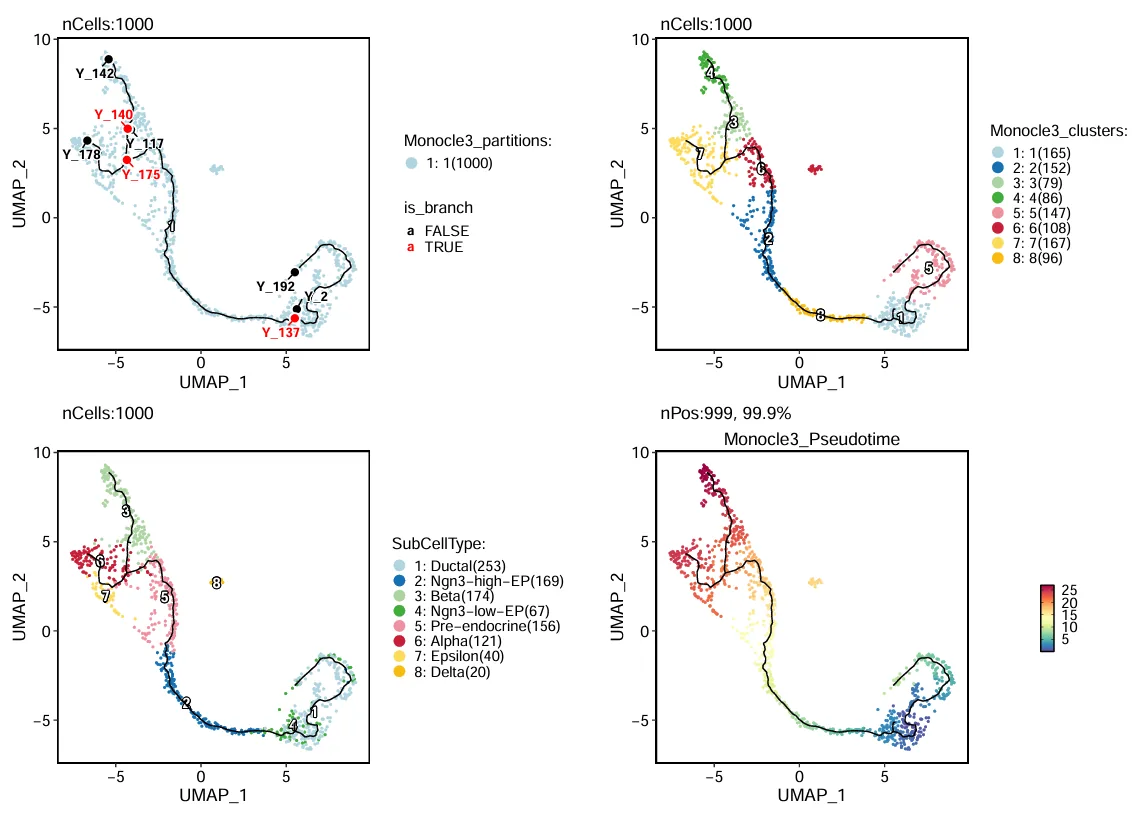
图 7|Slingshot轨迹推断
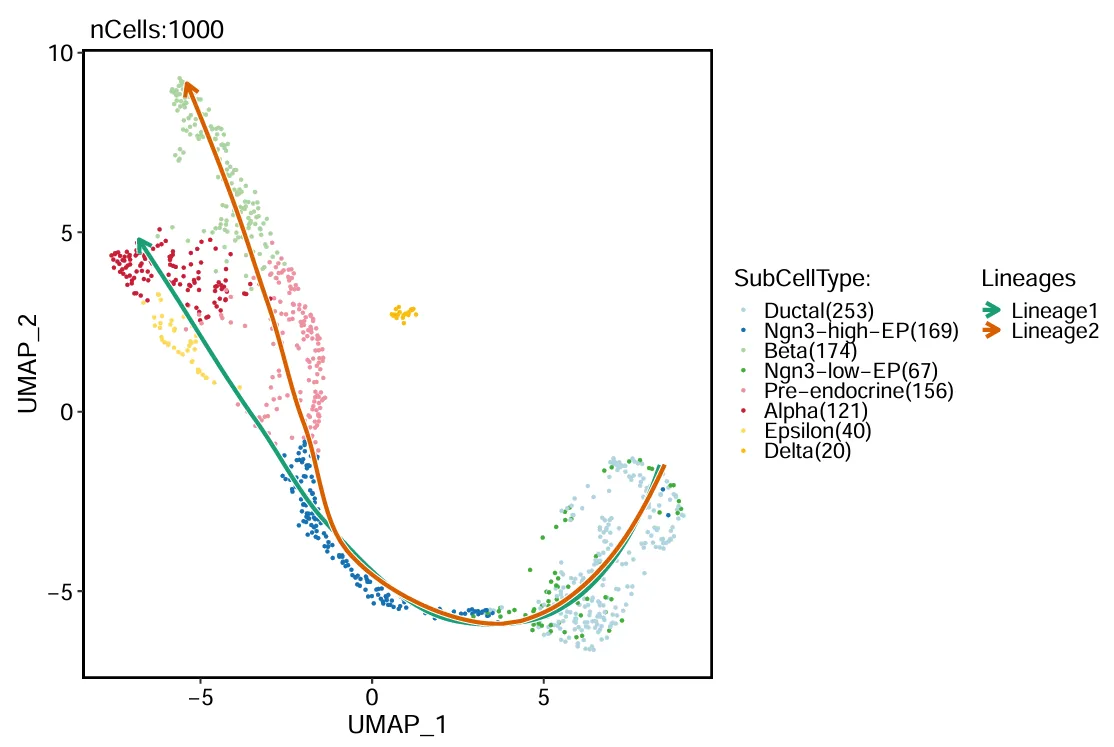
图 8|差异基因环形全景图
每个扇形一类细胞,红点为上调基因、蓝点为下调基因——一张图看全5大类型的标志基因。
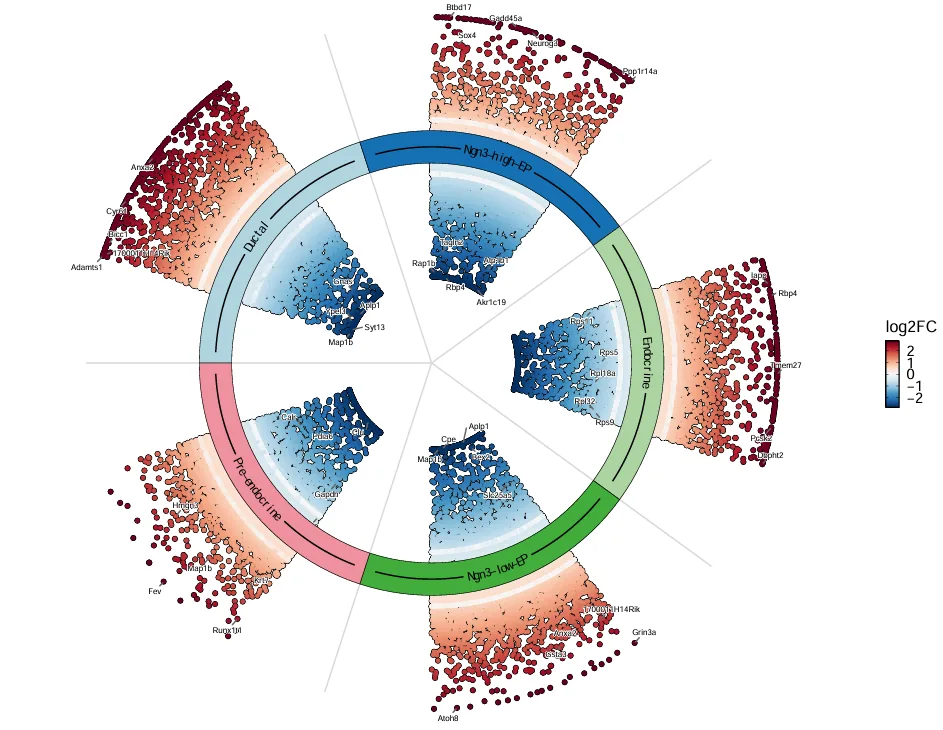
图 9|GO富集气泡图
5大类型各自的富集通路横向对比,气泡越大基因比例越高、颜色越红越显著——Ductal富集翻译相关通路、Endocrine富集激素分泌相关通路,与细胞功能相符。
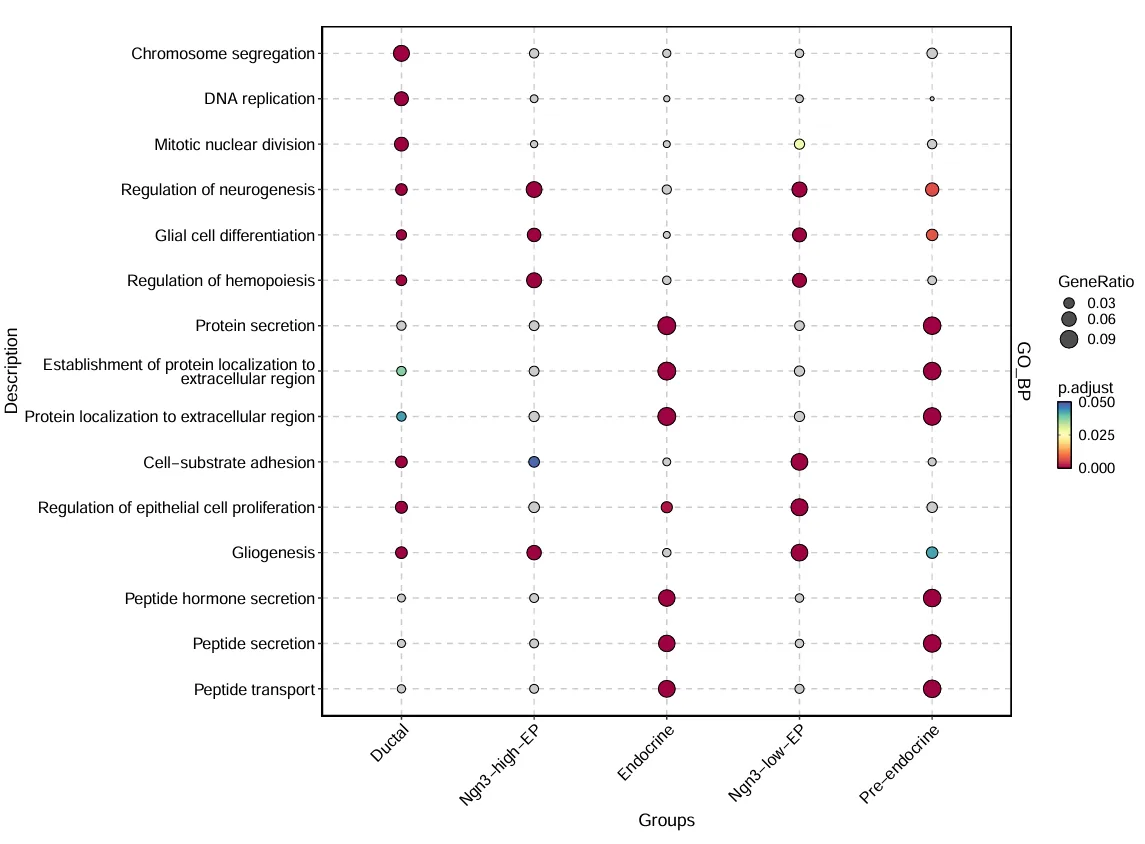
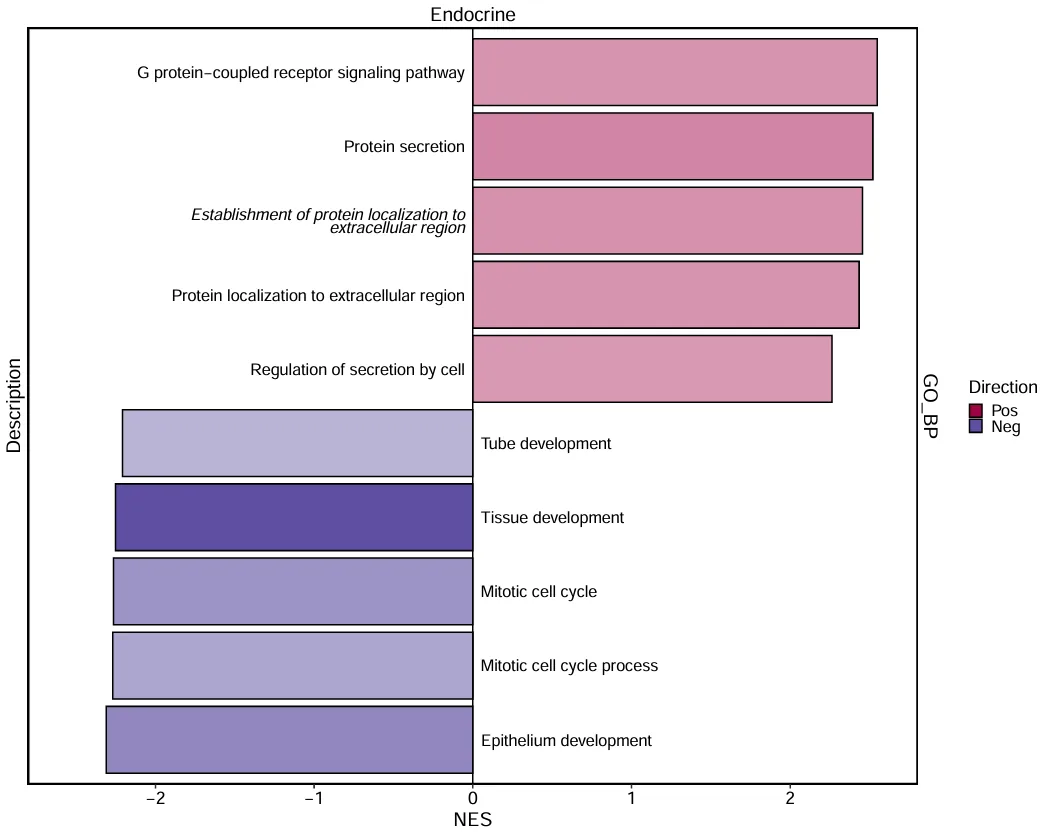
图 10|GSEA方向性条形图
Endocrine细胞中蛋白分泌、GPCR信号等通路整体上调,细胞周期相关通路下调——方向性与细胞功能高度吻合。
五、小结
SCOP = 一站式单细胞R包,一个包覆盖从质控到富集的完整流水线。
流程完整:从质控、标准化、整合、注释、干性、轨迹、差异到富集,一个包全覆盖。
高效产出:10个环节一天内全部跑通,25张结果图全部产出。
开箱即用:R包装进公共库、分析环境放进公共路径,一句命令进入R即可运行。
想体验"一个包做单细胞全流程",欢迎联系我们的技术团队开通账号。
如果想使用自己的数据,如果希望直接拿到分析结果,详情可咨询服务器销售顾问。
云生信顾问提供人工服务:数据处理、绘图与结果解读,按项目交付即可。