Appearance
环境代码都装好了,就等你来敲——云服务器上玩转 scTenifoldKnk 虚拟敲除
写在前面:想研究某个基因的功能,常规做法是做基因敲除实验——设计、构建、验证,一套流程下来又贵又慢。能不能先在电脑上”假装”把这个基因敲掉,看看下游哪些基因会跟着乱?这篇文章我们用 R 包 scTenifoldKnk,在一份真实项目的单细胞数据里虚拟敲除 CST6,整个过程在我们的云服务器上一次跑通,代码和结果全部分享出来。
一、什么是”虚拟敲除”
基因之间不是孤立的:A 基因可能促进 B 基因的表达,B 又抑制 C……连成一张”调控网络”。
scTenifoldKnk 的思路很直白,三步:
- 建网:用单细胞数据算出正常状态下基因之间”谁影响谁”的网络;
- 剪线:把目标基因伸出去影响别人的连线全部剪断——这就是”虚拟敲除”;
- 对比:把剪线前后的网络对齐比较,受影响越大的基因,越可能是目标基因的”下游”。
不用养细胞、不用做实验,几行 R 代码,几分钟出结果。它的价值在于:做实验之前先筛一遍——虚拟敲除显示影响巨大的基因,才值得花真金白银去验证。
二、跑之前:环境一行都不用配
做生信最劝退的往往不是分析本身,而是配环境。这次我们直接用云生信服务器上预装好的公共 R 环境 r_in_silico_knockout(R 4.4.3),所需的 7 个包全部就位:
- 激活公共 R 环境
登录云服务器后,首先需要激活已经部署好的 scTenifoldKnk 公共环境。
执行:
bash
source /media/share/share_code/scTenifoldknk/r_in_silico_knockout/bin/activate成功后,命令行前方会出现环境名称:
text
(r_in_silico_knockout) 用户名@服务器:表示环境已经激活。
此时启动 R:
text
R即可直接加载 scTenifoldKnk 所需的分析包:
r
library(qs)
library(Seurat)
library(scTenifoldKnk)
library(igraph)
library(ggrepel)
library(dplyr)
library(forcats)
如果所有包均正常加载,说明环境配置完成,可以开始后续分析。
注意:该环境位于公共目录 /media/share/share_code/scTenifoldknk/,由服务器统一维护。请勿在公共目录下修改、删除文件或直接保存分析结果。 2. 设置个人工作目录
公共环境只负责提供运行所需的软件和 R 包,分析过程产生的日志、图片和结果文件建议保存到自己的用户目录中。
例如,在自己的主目录下创建一个 scTenifoldKnk 分析文件夹:
bash
mkdir -p ~/sctenifoldknk_demo
cd ~/sctenifoldknk_demo
其中:
mkdir -p:创建分析文件夹;
cd:进入该文件夹。
进入后,可以检查当前工作路径:
bash
pwd输出类似:
text
/home/用户名/sctenifoldknk_demo表示当前已经切换到个人工作目录。
之后运行分析脚本:
bash
nohup Rscript /media/share/share_code/scTenifoldknk/scTenifoldknk.R \
> scTenifoldknk.test.log 2>&1 &
产生的:
日志文件 scTenifoldknk.test.log
分析结果文件
图片结果
都会保存在自己的工作目录中,不会影响其他用户。
三、数据和目标基因
直接上真家伙:一份皮肤来源单细胞转录组数据,先看它的”户口本”:
r
scRNA <- readRDS('/media/share/share_code/scTenifoldknk/data/01-HTRA2_pos.rds')
table(scRNA$celltype)
# Epithelial cell
#            3130
本次取其中的**上皮细胞(Epithelial cell,3130 个,HTRA2 阳性组)**做分析——上皮是皮肤屏障的第一线,也是 CST6 主要表达的场景。
要虚拟敲除的目标基因是 CST6(Cystatin E/M,一种半胱氨酸蛋白酶抑制因子,与表皮分化和皮肤屏障功能密切相关)。
四、核心分析:十几行代码搞定
从 29877 个基因里先挑出 2000 个”变化最活跃”的高变异基因,再把目标基因加进去,取表达量最高的前 1000 个细胞:
r
sce <- subset(scRNA, subset = celltype == "Epithelial cell")
countMat <- GetAssayData(sce, layer = "counts")

sce <- FindVariableFeatures(sce, selection.method = "vst", nfeatures = 2000)
hvgs <- VariableFeatures(sce)

target_gene <- "CST6"
target_gene <- intersect(rownames(sce), target_gene)
cat("target_gene:", paste0(target_gene, collapse = ", "))
data <- as.data.frame(countMat[unique(c(target_gene, hvgs)), ])

cell_mean <- colMeans(data, na.rm = TRUE)
data <- data[, order(cell_mean, decreasing = TRUE)[1:min(1000, ncol(data))]]
然后就是本次的主角——scTenifoldKnk() 一个函数完成”建网→剪线→对比”全流程:
r
result <- scTenifoldKnk(countMatrix = data,
                        gKO = target_gene,   # 要虚拟敲除的基因
                        qc = TRUE,           # 先做质控
                        qc_mtThreshold = 0.1,  # 线粒体reads占比阈值
                        qc_minLSize = 1000,    # 最小文库大小
                        nc_nNet = 10,        # 建10个子网络
                        nc_nCells = 250)     # 每个子网络随机抽250个细胞
数据量不大,但为了稳妥我们还是用 nohup 挂到后台跑,断开 SSH 也不怕。工作目录设到自己目录(首次使用先创建),日志和结果文件都写在这里:
bash
mkdir -p ~/sctenifoldknk_demo
cd ~/sctenifoldknk_demo
nohup Rscript /media/share/share_code/scTenifoldknk/scTenifoldknk.R > scTenifoldknk.test.log 2>&1 &
五、跑通!日志一步一个勾
打开日志,scTenifoldKnk 的每一步都打了勾,全程零报错:
text
── scTenifoldKnk ──────────────────────────────────────
ℹ Simulating CST6 gene knockout
✔ Count matrix quality control applied: retained 2000 genes and 932 cells
✔ Network construction complete (nNet = 10, nCells per net = 250)
✔ Tensor decomposition completed (K = 3)
✔ Prepared WT adjacency matrix for KO simulation
✔ Simulated knockout for CST6
✔ Manifold alignment completed (d = 2)
✔ Differential regulation computed for CST6
✔ Finished scTenifoldKnk for CST6
质控后 2000 个基因、932 个细胞进入分析;10 个子网络、张量分解、流形对齐一气呵成。
六、结果:敲掉 CST6,谁最受伤?
直接看差异调控结果表(按显著性排序):
| 基因 | Z 值 | FC | p.value |
|---|---|---|---|
| CST6 | 5.34 | 99626.4 | 0 |
| PTGER2 | 3.28 | 791.3 | 4.2e-174 |
| AMN | 3.28 | 790.2 | 7.5e-174 |
| HSPA2 | 2.05 | 16.4 | 5.2e-05 |
| SNCG | 2.01 | 14.2 | 1.6e-04 |
| RGS10 | 1.92 | 10.2 | 1.4e-03 |
CST6 自己排第一(它被”剪”了,变化当然最大——这反而验证了方法的灵敏度)。真正值得关注的是后面几位:PTGER2(前列腺素 E2 受体,炎症信号关键分子)、AMN、HSPA2(热休克蛋白)等,提示 CST6 可能通过这些基因影响上皮细胞状态。
图 1|调控网络图:CST6位于网络中心位置,与PTGER2、AMN及HSPA2等候选响应基因之间存在正向网络关联(红色连线表示正向边权关系)。需要注意的是,该结果反映的是基于单细胞转录组数据推断得到的基因网络关系,提示这些基因可能受到CST6扰动的影响
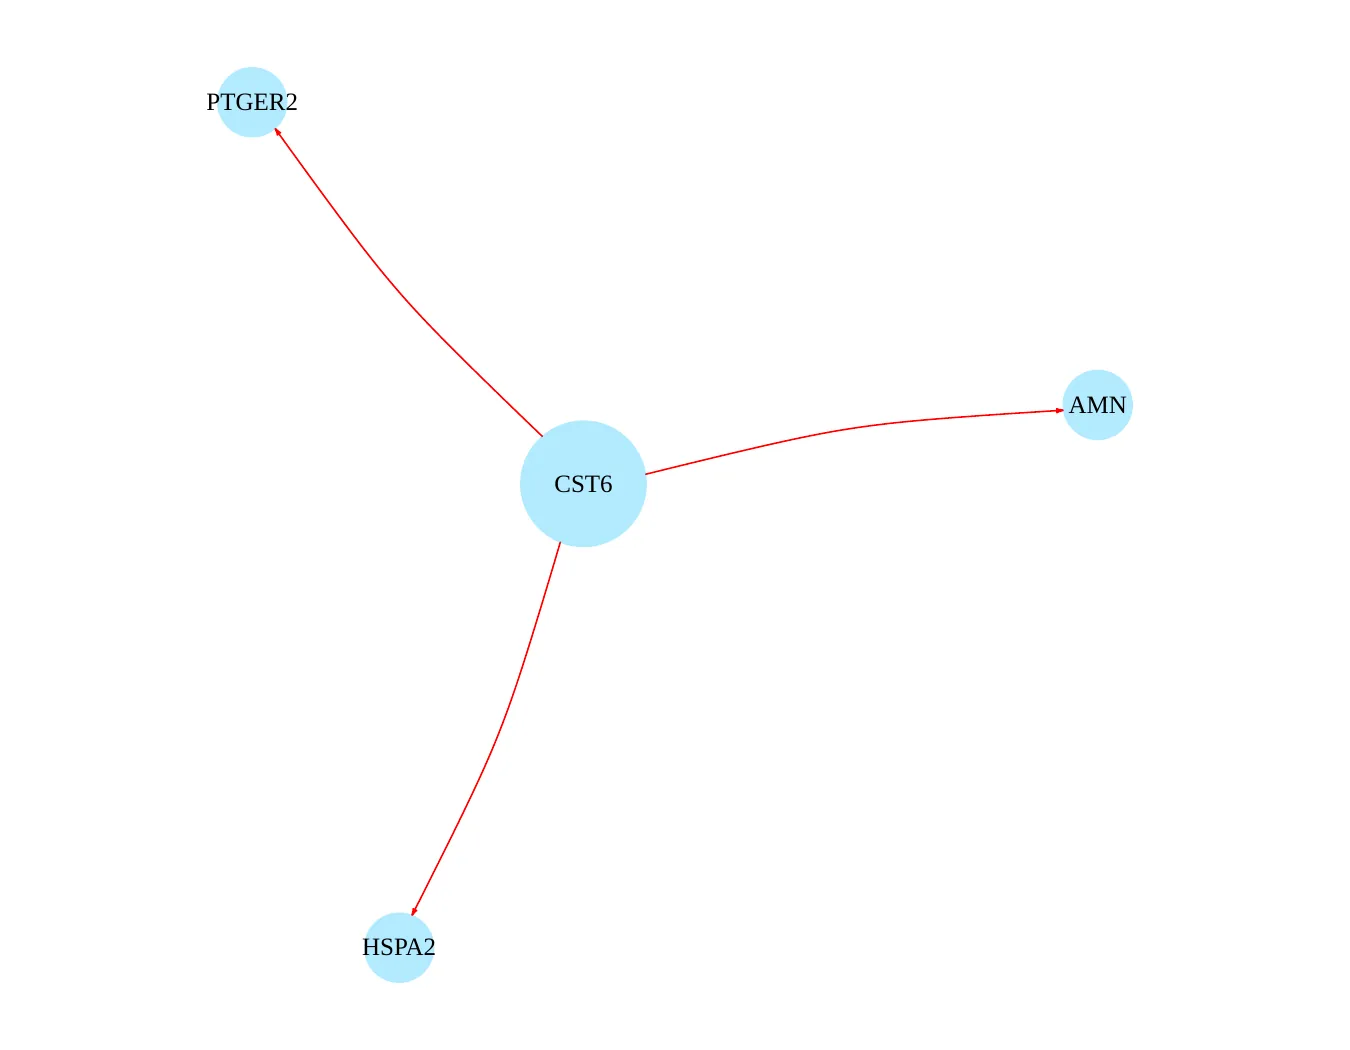
CST6 位于网络中心,并与候选响应基因呈正向网络关联。
图 2|Top 20 差异调控基因条形图:CST6 一骑绝尘(log2FC=16.6),PTGER2、AMN 紧随其后(9.6),往下依次是 HSPA2、SNCG、RGS10、RARRES1 等。
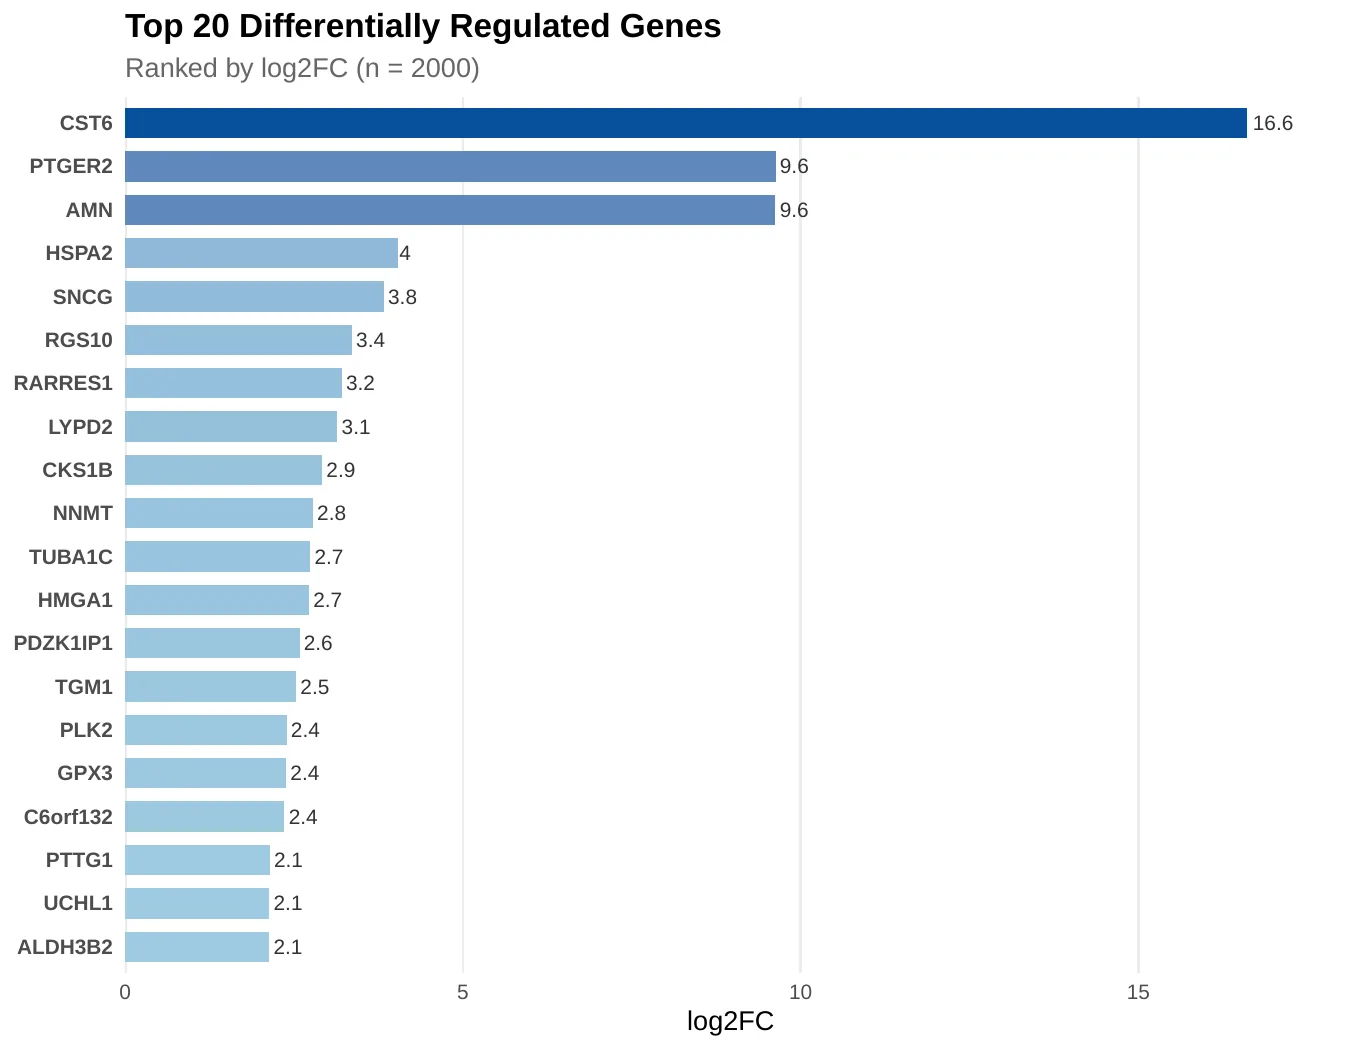
按差异调控强度排列的前 20 个候选基因。
图 3|火山图:横轴 Z 值、纵轴 -log10(p),PTGER2 和 AMN 一飞冲天,远超显著阈值线。
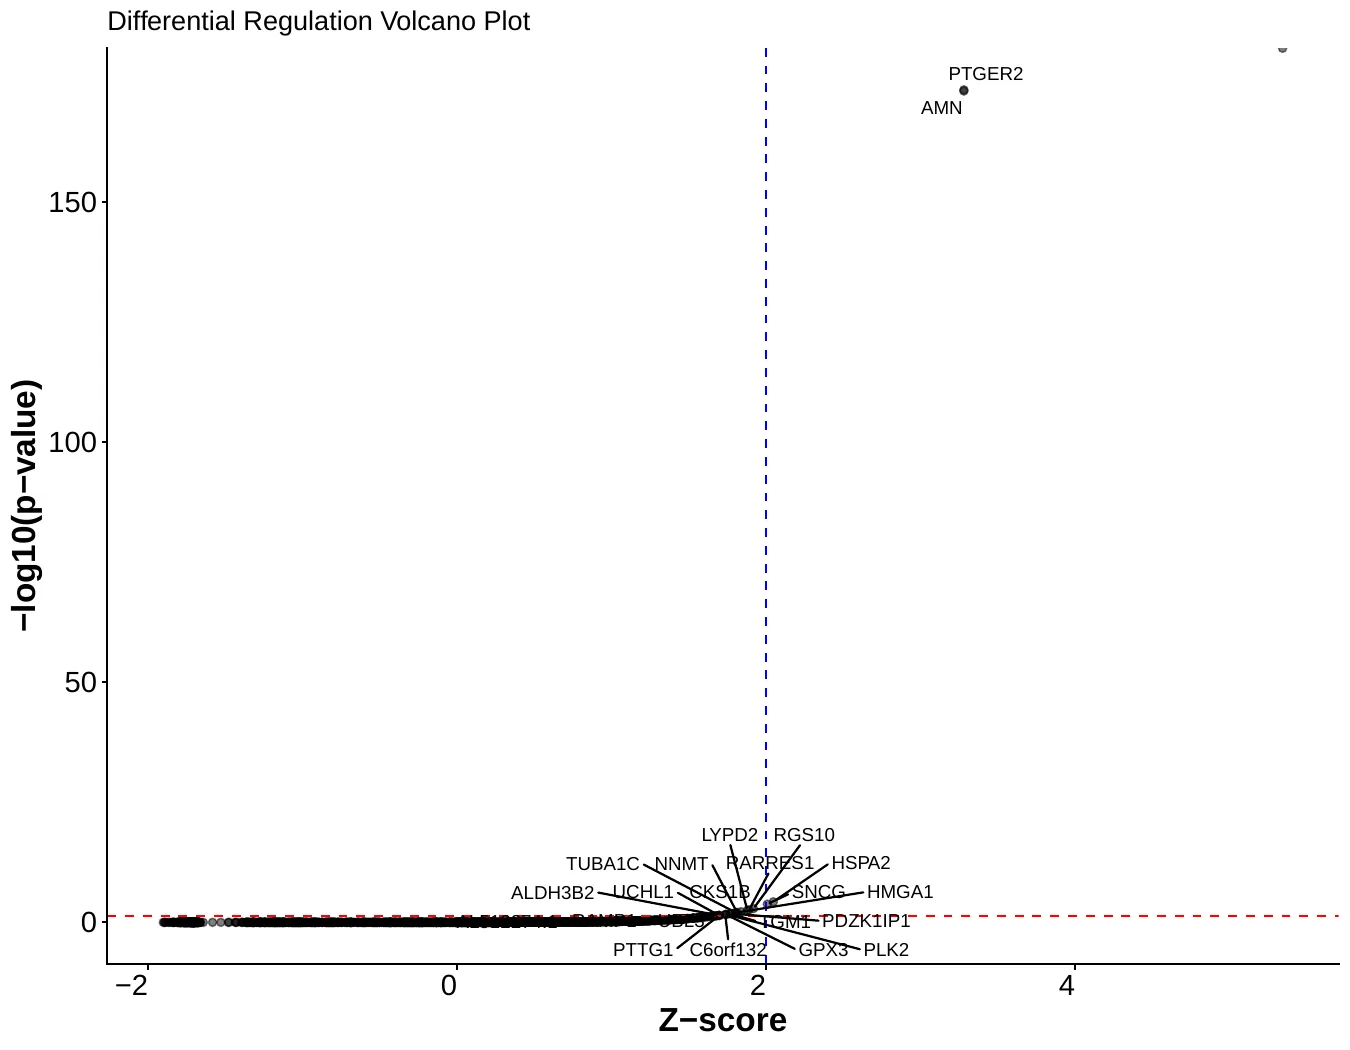
横轴为 Z 值,纵轴为 `-log10(p)`;靠右上方的基因差异更显著。
图 4|关键基因表达分布:CST6、HSPA2、NNMT 在上皮细胞中的表达量分布(小提琴图)。三个基因都呈”少数细胞高表达”的形态——表达虽不普遍,调控作用却很关键,这正是单细胞分析才能看到的细节。
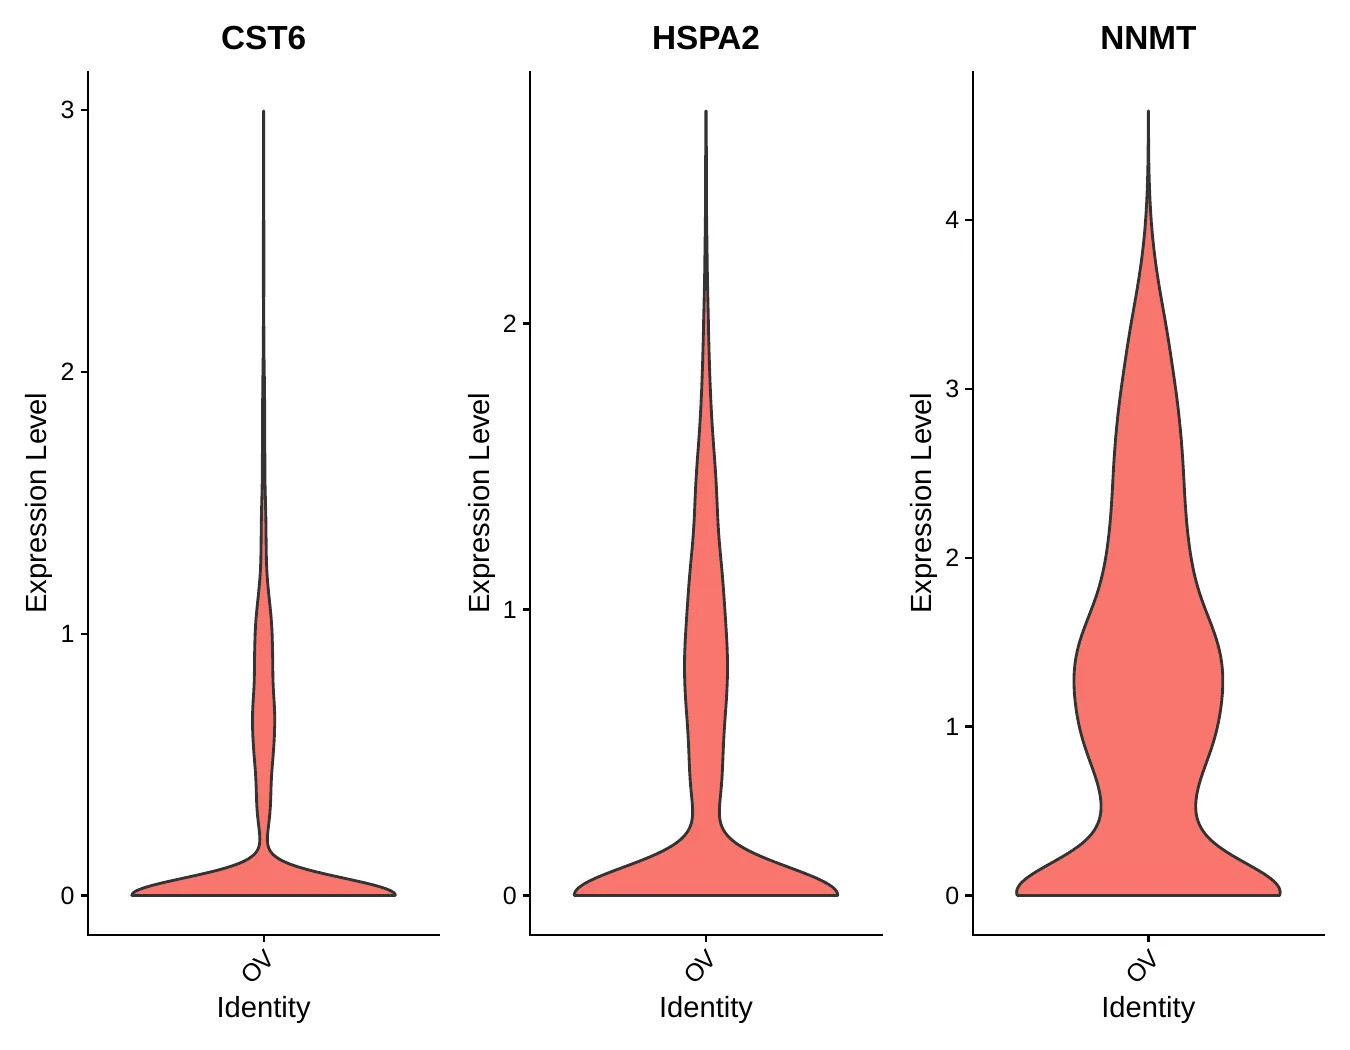
CST6、HSPA2 与 NNMT 在上皮细胞中的表达分布。
图 5|敲除响应基因集打分:把 Top20 受影响基因做成一个集合打分(KO_CST61),映射回 UMAP 细胞图上——颜色越蓝的区域,受 CST6 敲除影响越大的细胞越集中(本批数据为 HTRA2 阳性组,暂不做组间对比)。
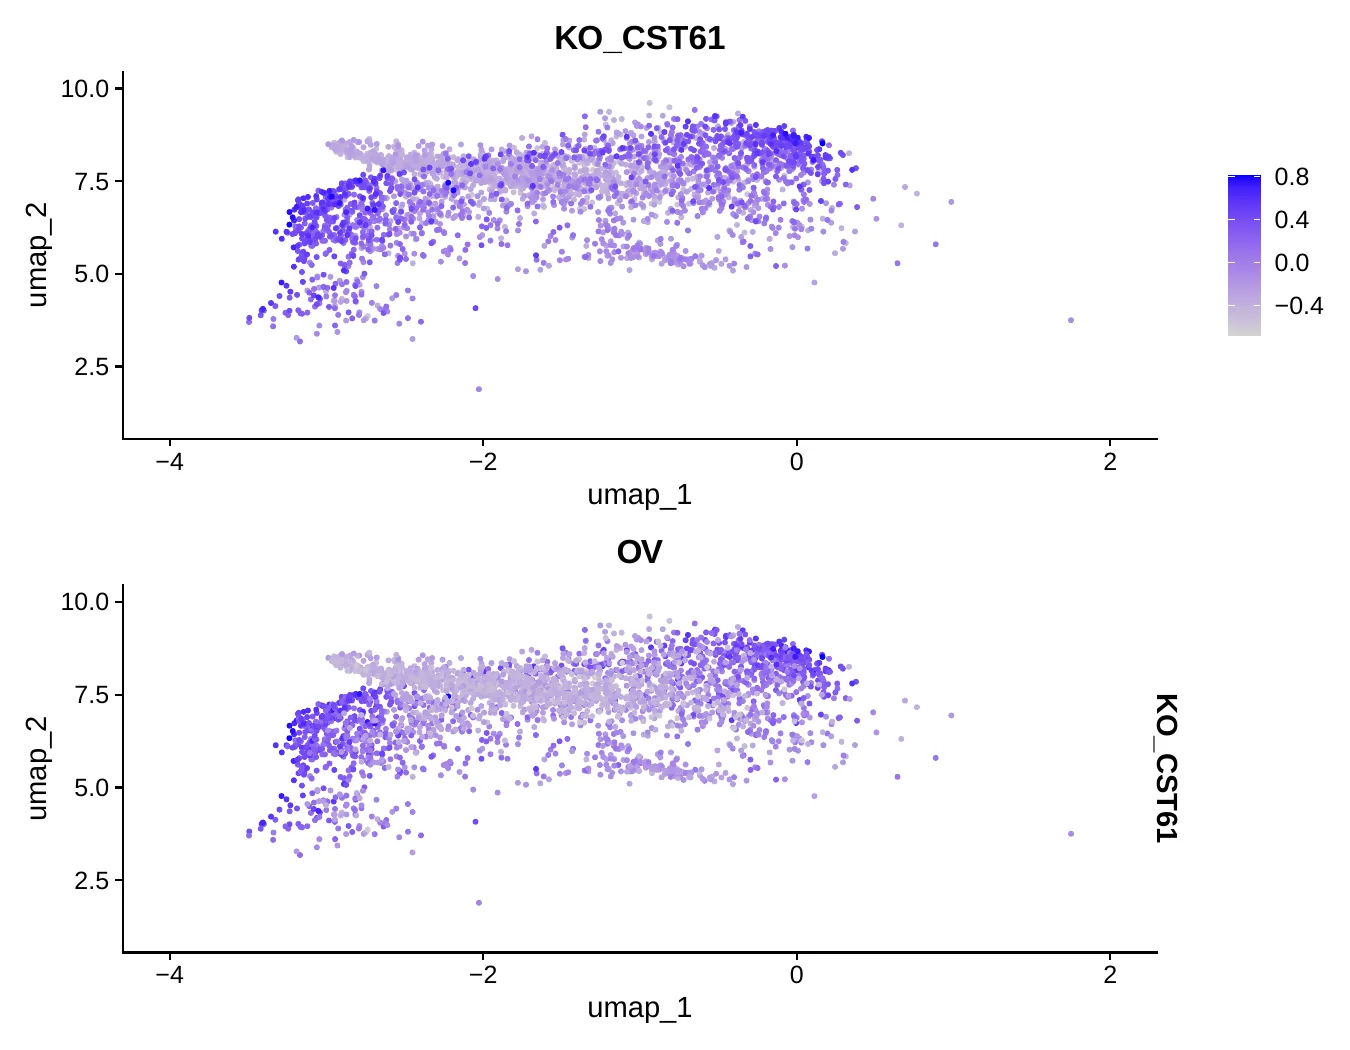
颜色更深的区域表示细胞受到 CST6 敲除影响的可能性更高。
七、小结与下一步
回顾一下,这次分析做了什么:
- 在公共 R 环境下零配置跑通 scTenifoldKnk;
- 对一份项目数据中的 3130 个上皮细胞虚拟敲除 CST6;
- 筛出 PTGER2、AMN、HSPA2 等一批潜在下游基因,为后续实验验证提供了明确候选。
scTenifoldKnk 一次敲一个基因,而我们手上已经有一整份目标基因清单(项目要求逐一考察的基因都在里面)——这次为了节约测试时间只敲了 CST6,下一步把脚本改成按清单批量虚拟敲除,一键出全套结果。
这套流程已经部署在云生信服务器上,环境预装、开箱即用:带上你自己的单细胞数据和想研究的基因,登录就能跑出同款结果。有公网数据或环境方面的需求,也欢迎随时联系我们的技术团队。
本文的分析代码、示例数据与公共 R 环境已在服务器公共路径(/media/share/share_code/scTenifoldknk/)归档,供参考复现;按上文在自己目录下运行,即可生成同款结果。