Appearance
环境代码都装好了,就等你来跑——云服务器上玩转 scMetabolism 单细胞代谢活性分析
写在前面:单细胞转录组能告诉我们每个细胞"表达了哪些基因",但细胞真正在"干什么"——是在开足马力供能,还是静息蛰伏——光看表达量并不直观。代谢才是细胞功能的直接执行层。scMetabolism 做的就是把表达矩阵换算成"每个细胞 × 每条代谢通路"的活性分数,让代谢状态看得见、比得了。这套流程已部署在云生信服务器上,环境、代码、示例数据全部就位,登录即用。
一、什么是 scMetabolism
scMetabolism 是 2021 年发表在 Cancer Discovery 上的单细胞代谢分析工具(Yingcheng Wu, Qiang Gao 等),思路一句话:
输入:单细胞表达矩阵(Seurat 对象即可);
打分:内置 KEGG / REACTOME 代谢通路基因集,用 AUCell、VISION、ssGSEA、GSVA 四种方法任选其一,给每个细胞的每条代谢通路算一个活性分数;
输出:一张"通路 × 细胞"的代谢活性矩阵,以及配套的热图、点图、箱线图、UMAP 映射图。
有了活性分数,"M1 型和 M2 型巨噬细胞的代谢偏好差在哪""疾病组相对对照组哪条通路被点燃"这类问题,直接从图上读答案。
二、跑之前:环境一行都不用配
做生信最劝退的往往不是分析本身,而是配环境。这次直接用服务器上预装好的公共 R 环境 r_sc_metabolism,一条命令激活:
bash
conda activate r_sc_metabolism命令行提示符前出现 (r_sc_metabolism) 前缀,就说明环境激活成功。Seurat、AUCell、scMetabolism 等全部依赖都已装好,登录即用。
环境的部署与更新由技术团队统一维护,大家调用的是同一份公共环境;工作目录请设到自己的目录下,不在公共路径里读写。
三、示例数据:一份注释好的单细胞对象
示例数据已放在公共路径,是一份完成了质控、降维聚类和细胞类型注释的 Seurat 对象:
r
scRNA <- readRDS("/media/share/share_code/scMetabolism 一站式完整教程/01_SingleCell_Analysis_Complete.rds")先看它的"户口本":4477 个细胞、25169 个基因;细胞类型上分为 M1_M(3982 个)和 M2_M(495 个)两类巨噬细胞亚群;分组上 Control 2524 个、Disease 1953 个。细胞类型和分组信息都在 meta.data 里,可以直接拿来做分组比较。
四、一行命令,跑完整个分析
分析脚本同样已在公共路径归档,核心参数如下:
打分方法 method = "AUCell";通路数据库 metabolism.type = "KEGG";不做表达插补 imputation = FALSE;ncores = 2。
AUCell 的特点是先对每个细胞做基因排名、再算通路基因集的 AUC 富集分数,不需要插补就能稳健运行,几十条 KEGG 代谢通路一次全部打完分。
首次使用,先在自己目录下建一个工作文件夹,然后一条 Rscript 开跑(注意:项目目录名带空格,命令里的路径必须带引号):
bash
mkdir -p ~/scmetabolism_demo
cd ~/scmetabolism_demo
Rscript "/media/share/share_code/scMetabolism 一站式完整教程/scMetabolism_Analysis.r"
想挂后台跑、断开 SSH 也不怕的话,用 nohup:
bash
nohup Rscript "/media/share/share_code/scMetabolism 一站式完整教程/scMetabolism_Analysis.r" > scMetabolism.log 2>&1 &脚本输入从公共路径读取,结果输出到你的当前工作目录下的 01.scMetabolism_Analysis 文件夹——公共路径只读不写,各人结果各自归档。
五、结果:七张图读懂代谢全景
跑完后打开 01.scMetabolism_Analysis 目录,7 张结果图按"总览 → 比较 → 定位"的逻辑层层递进。先说结论:M2_M 亚群的氧化磷酸化活性显著高于 M1_M,而 M1_M 整体代谢更旺——这正是免疫学上"M1 型靠糖酵解快速供能、M2 型靠氧化磷酸化持续供能"的经典代谢重编程结论,工具把已知生物学事实稳稳复现,说明整条分析链路可靠。
图 1|细胞类型全景:UMAP 上 M1_M(红)与 M2_M(青绿)两大亚群各自成团、界线分明——先看细胞分得开不开,再看代谢差多少。
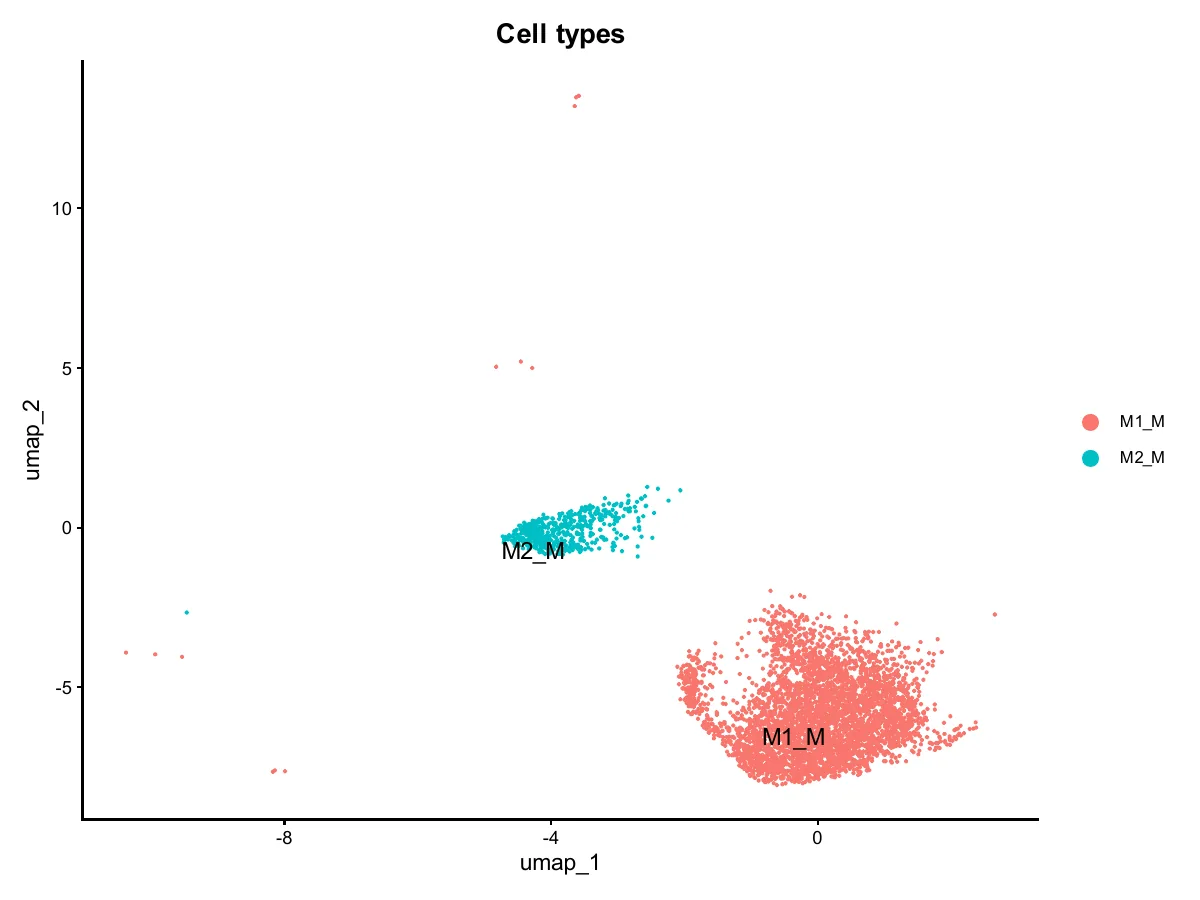
细胞类型UMAP全景
图 2|细胞类型代谢热图:每列一条 KEGG 代谢通路,两行分别是 M1_M 与 M2_M 的平均活性(z-score)。格局非常清晰——绝大多数通路 M1_M 更高(红色块),而 M2_M 只有一小撮通路逆势升高(右侧蓝色块),其中最扎眼的就是氧化磷酸化。
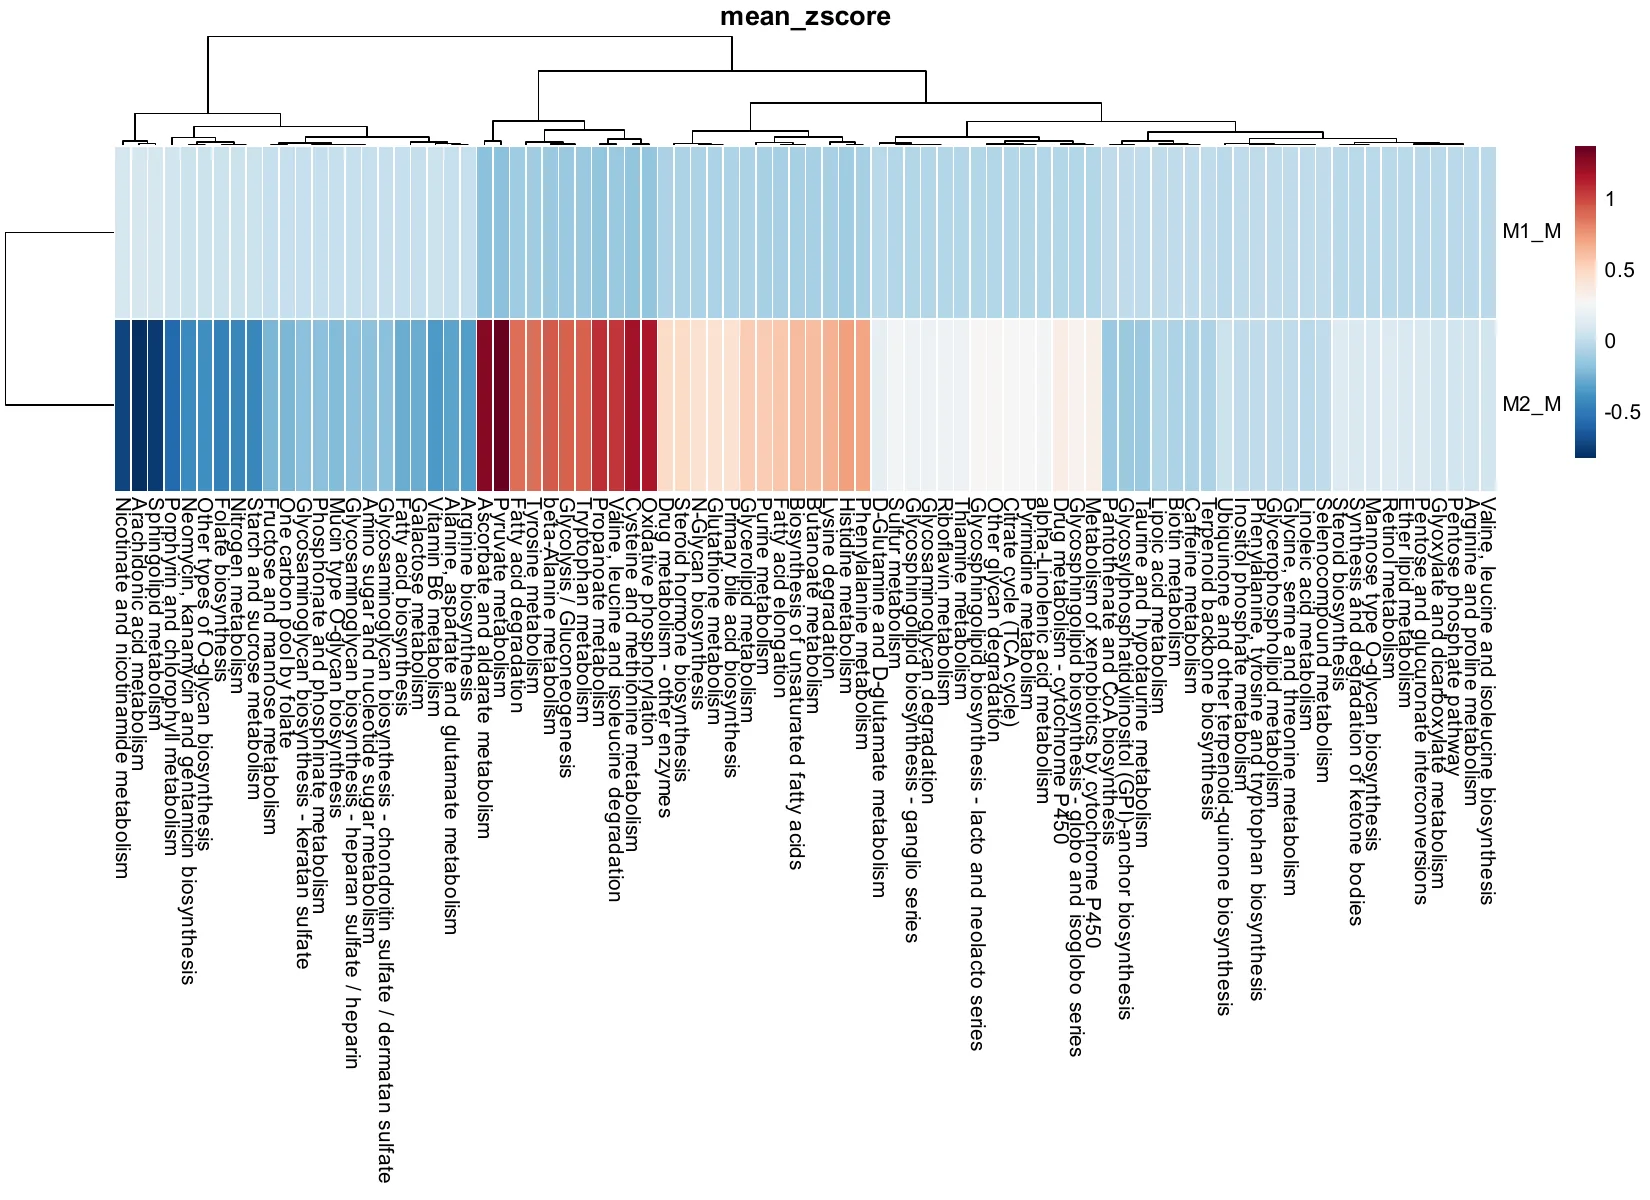
细胞类型代谢活性热图
图 3|细胞类型×分组热图:在细胞类型基础上再拆 Control / Disease 两层。M2_M 里那撮高活性通路(氧化磷酸化领衔)在 Disease 组进一步走高,而 M1_M 整体格局在两组间基本稳定——疾病相关的代谢变化主要集中在 M2_M 亚群。
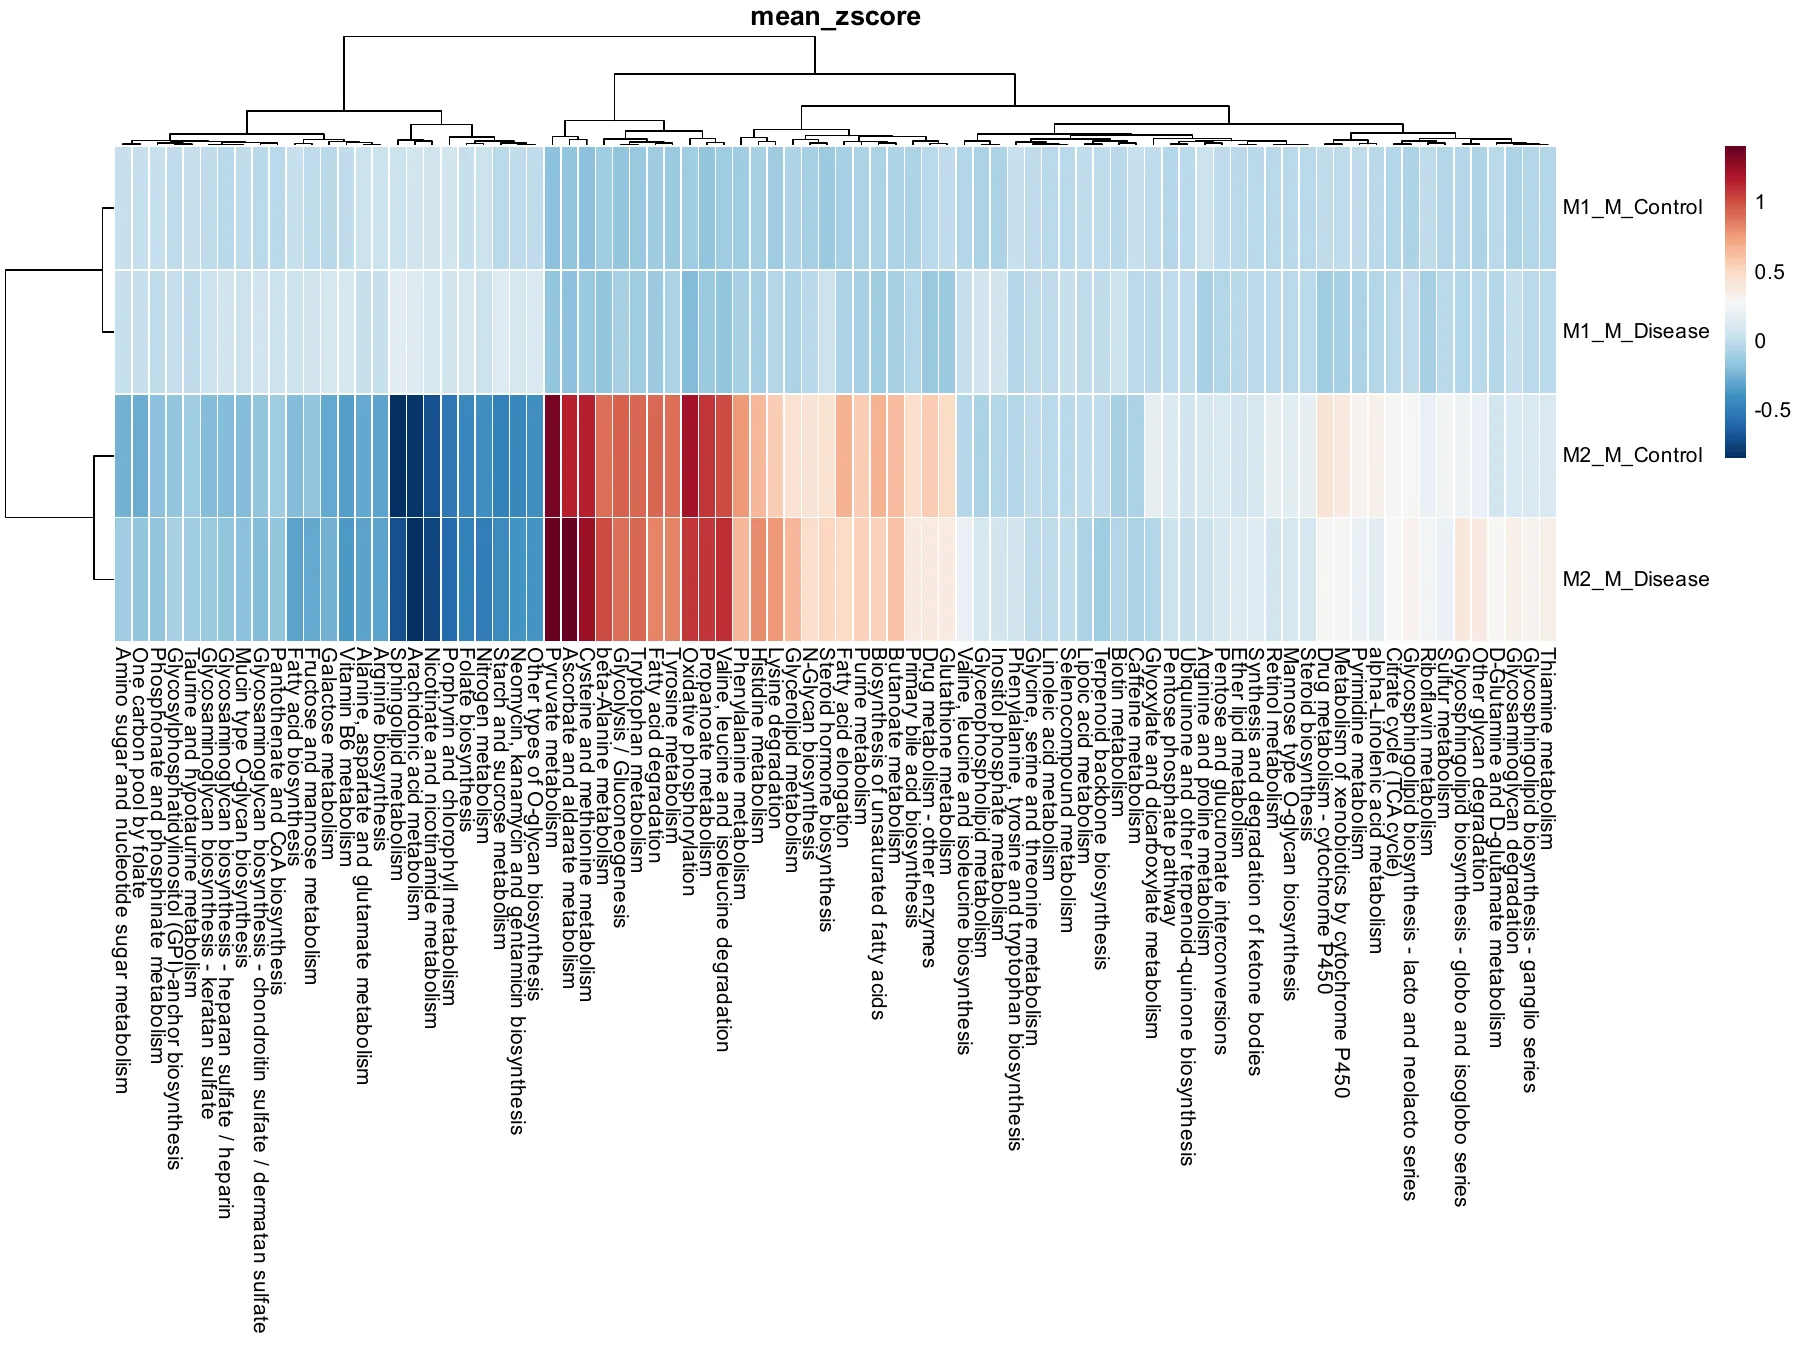
细胞类型×分组代谢热图
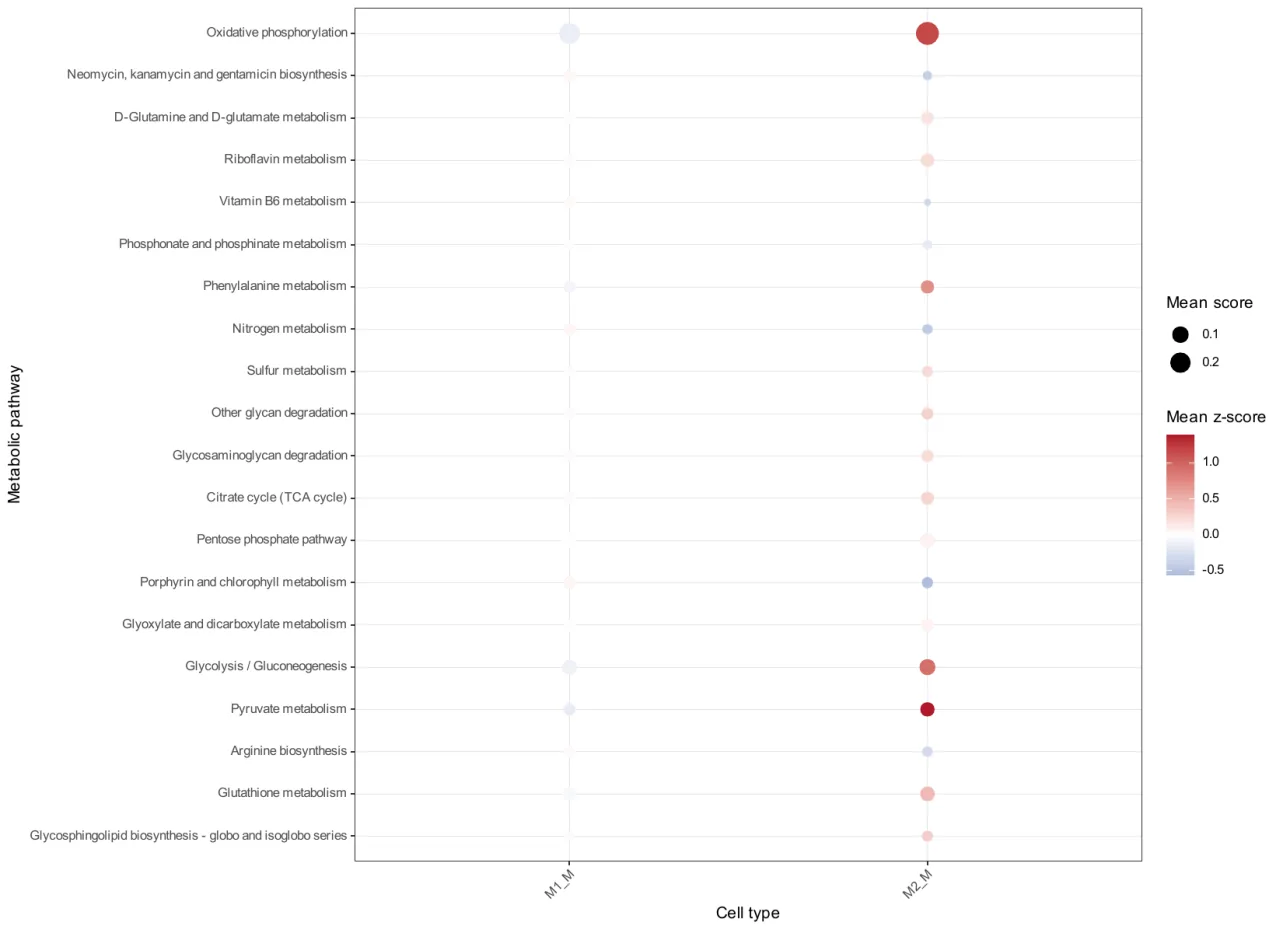
图 4|Top 通路点图:颜色为平均 z-score、点大小为平均活性分数。氧化磷酸化在 M2_M 上一骑绝尘——又红又大的圆点直接把"招牌通路"的身份坐实了。
Top代谢通路点图
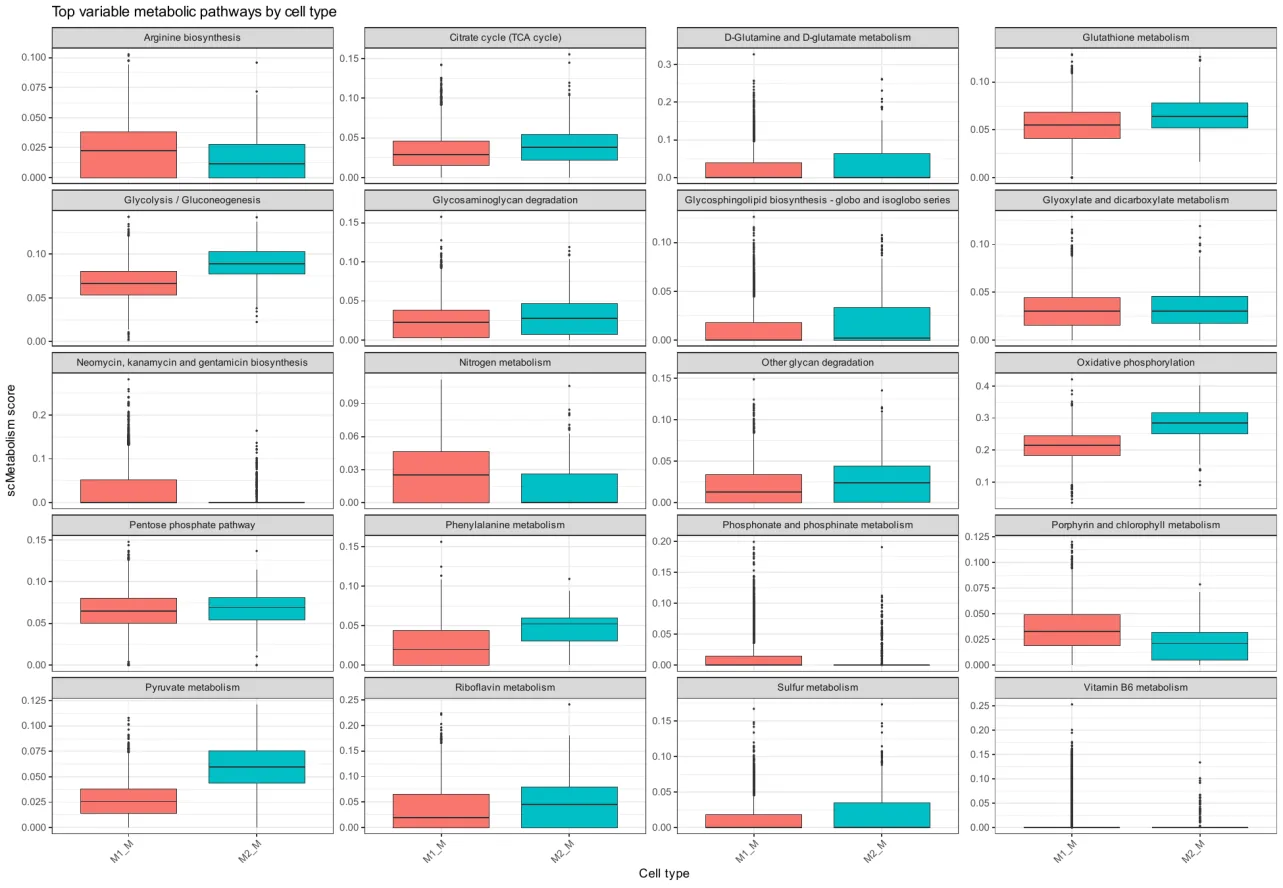
图 5|细胞类型间比较箱线图:变异度最高的 20 条通路逐一对比。氧化磷酸化 M2_M 中位数约是 M1_M 的两倍以上,且箱体几乎不重叠;此外糖酵解/糖异生、TCA 循环等核心供能通路也呈现稳定的亚群偏好。
细胞类型间通路比较
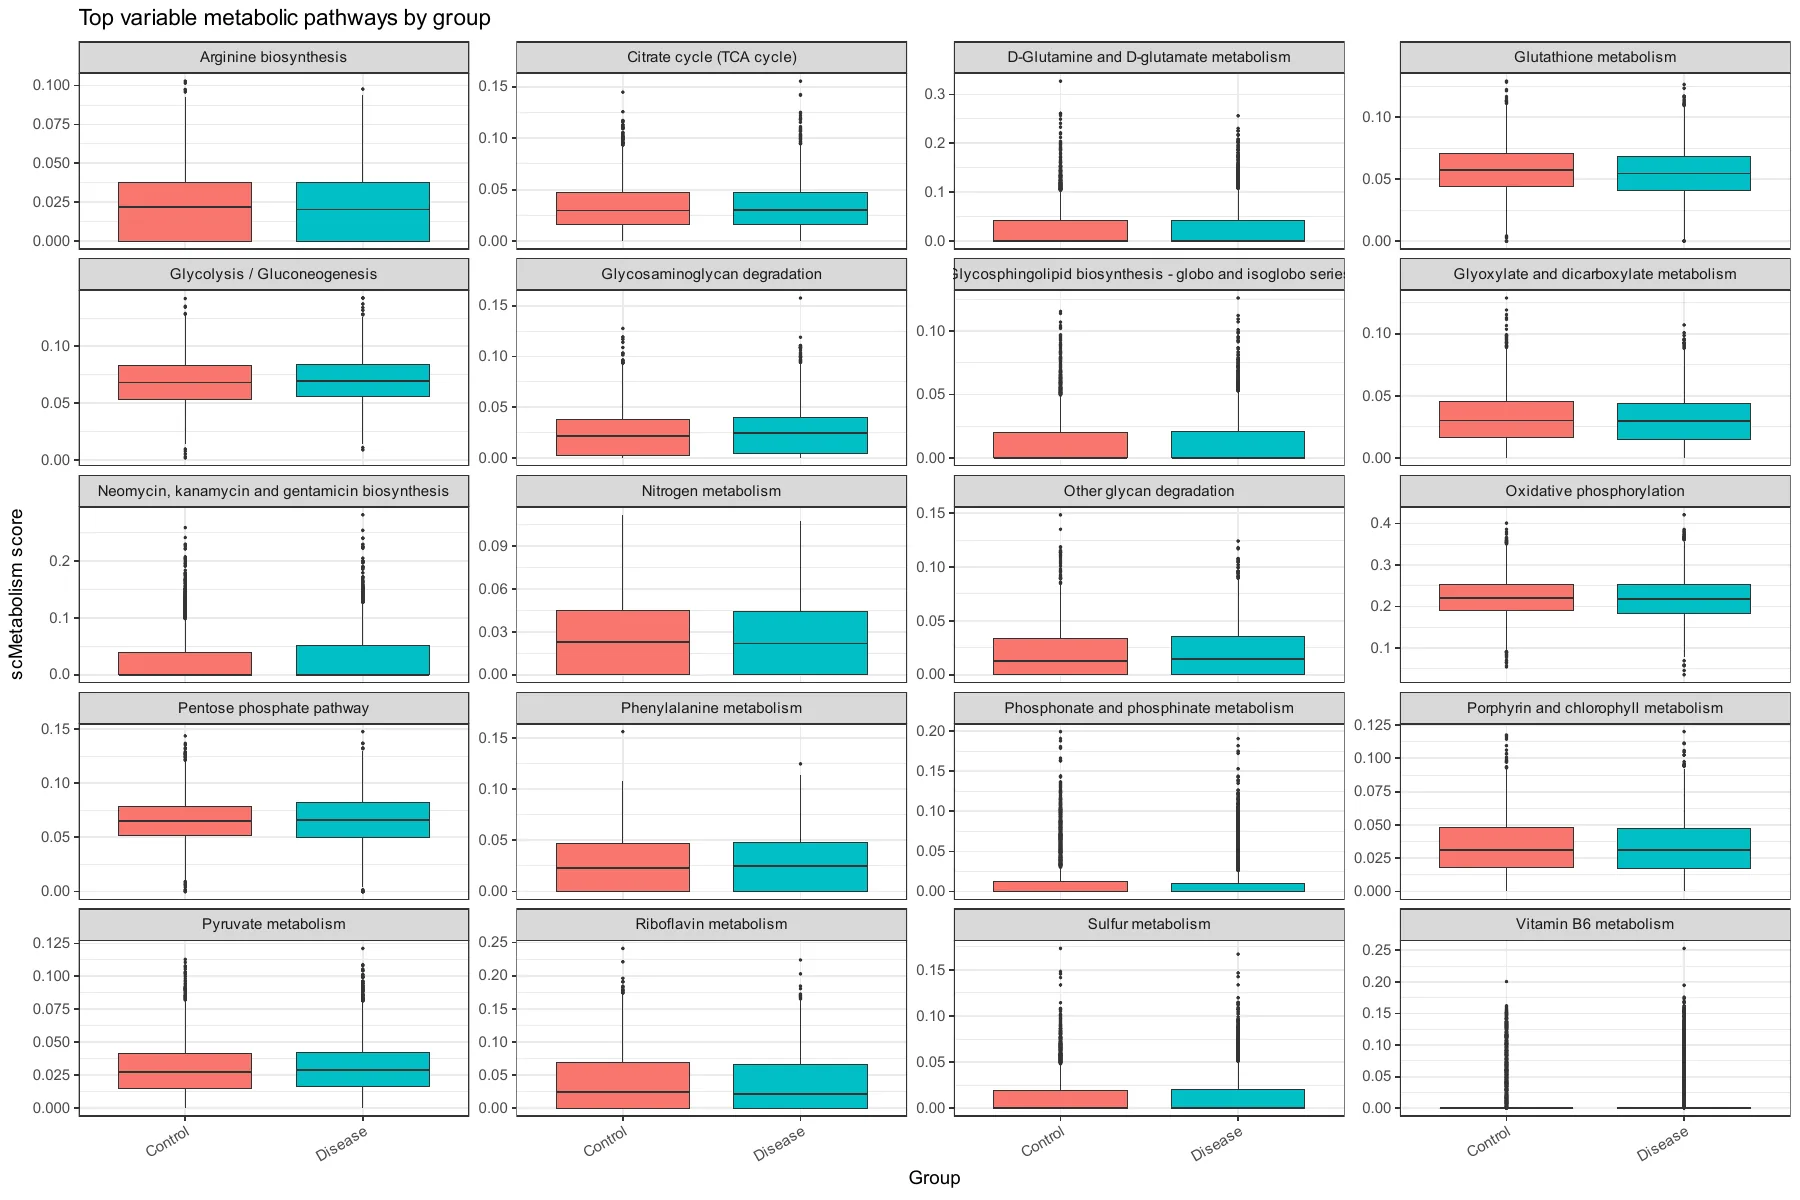
图 6|分组间比较箱线图:Control 与 Disease 直接对比,氧化磷酸化在 Disease 组整体抬升,与图 3 热图互相印证。
分组间通路比较
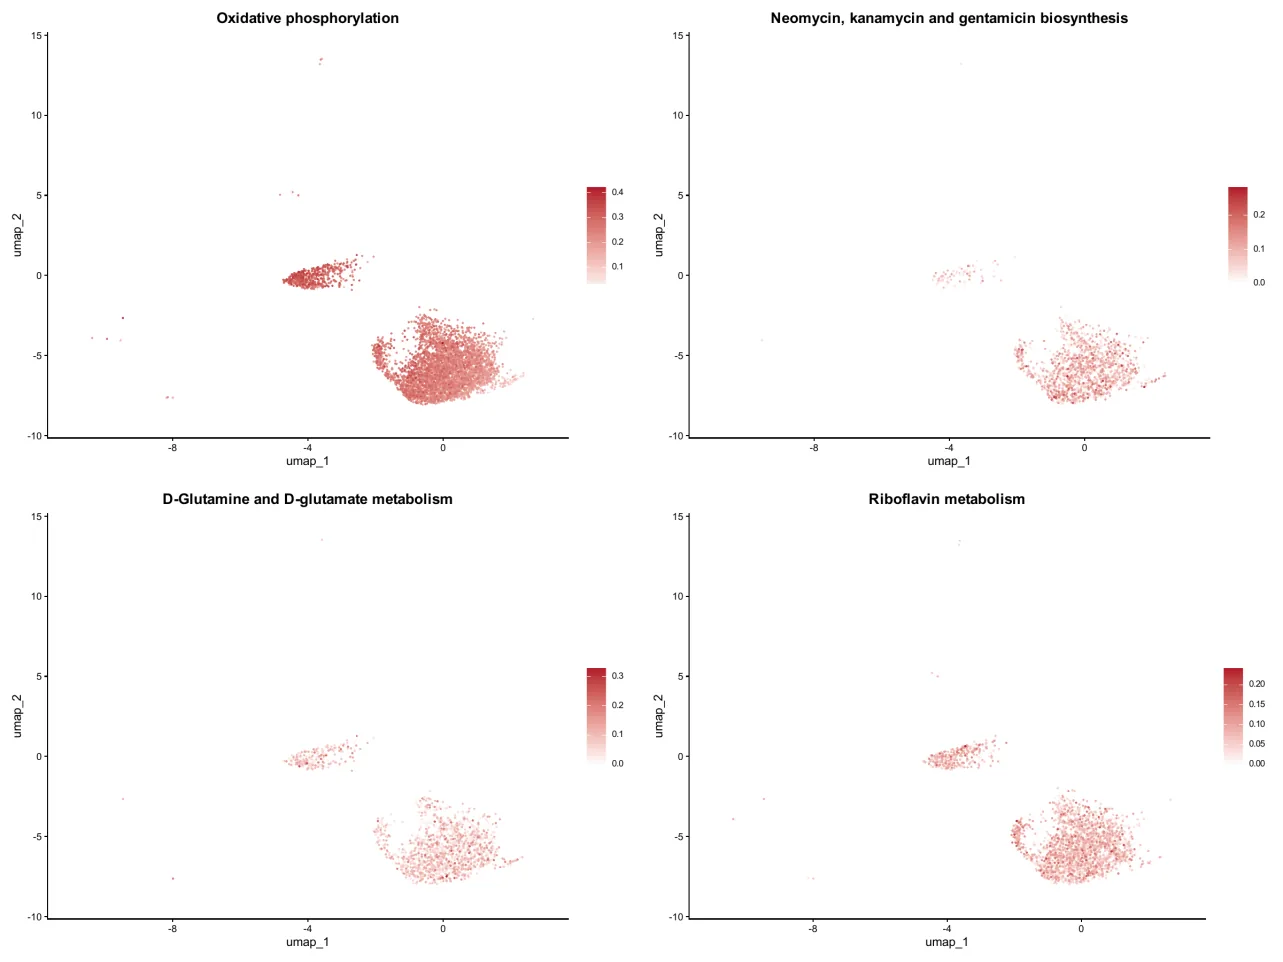
图 7|通路活性 UMAP 映射(Top 4 变异通路拼图):氧化磷酸化的活性热点精确落在 M2_M 细胞群上,红色越深活性越高——代谢差异来自哪群细胞,空间位置清清楚楚。
通路活性UMAP映射(Top4通路)
六、小结
回顾一下,这次分析做了什么:
在公共 R 环境 r_sc_metabolism 下零配置跑通 scMetabolism;
对 4477 个细胞一次性完成数十条 KEGG 代谢通路的活性定量(AUCell 法);
从细胞类型和疾病分组两个维度,读出了 M1_M / M2_M 亚群及 Control / Disease 之间的代谢差异格局。
这套流程已经部署在云生信服务器上,环境预装、开箱即用:带上你自己的单细胞数据(只要是注释好细胞类型的 Seurat 对象),登录就能跑出同款结果。
本文的分析代码、示例数据与公共 R 环境已在服务器公共路径(/media/share/share_code/)归档,结果输出在运行者自己的目录生成。参考文献:Yingcheng Wu, Qiang Gao, et al. Cancer Discovery, 2021. https://pubmed.ncbi.nlm.nih.gov/34417225/